 YouTube ↗
 Bilibili
数据驱动的 VAT 动画
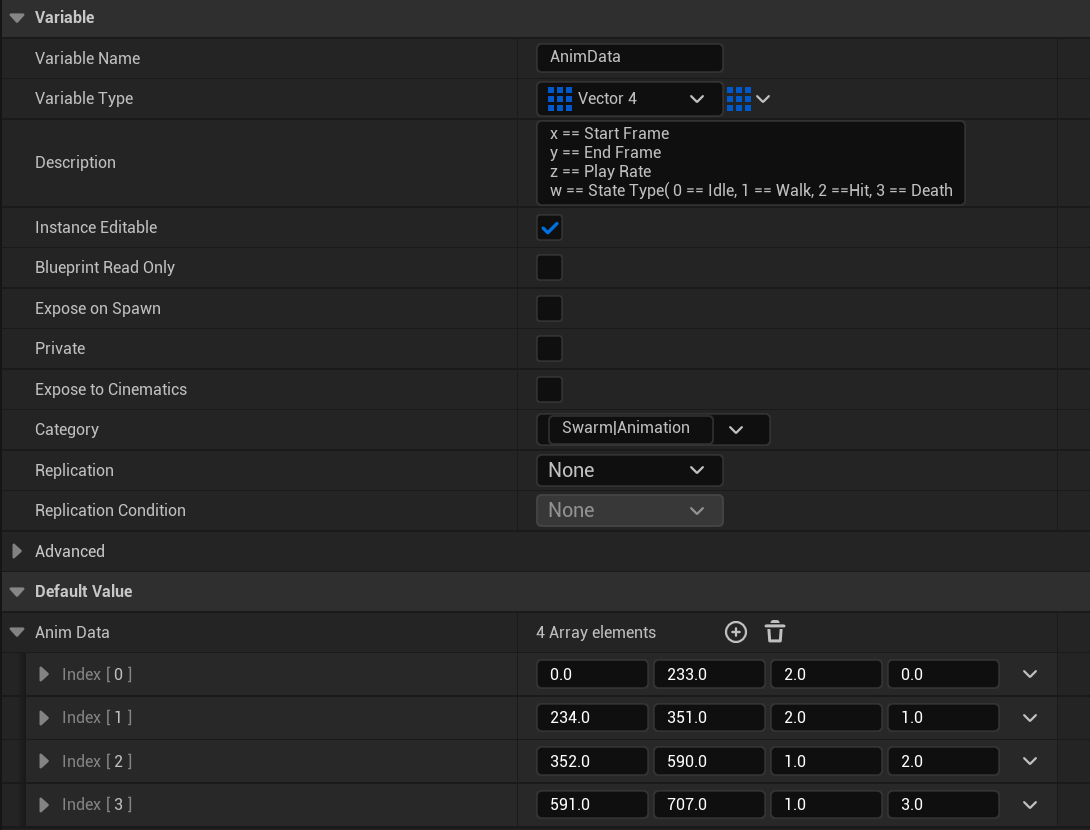
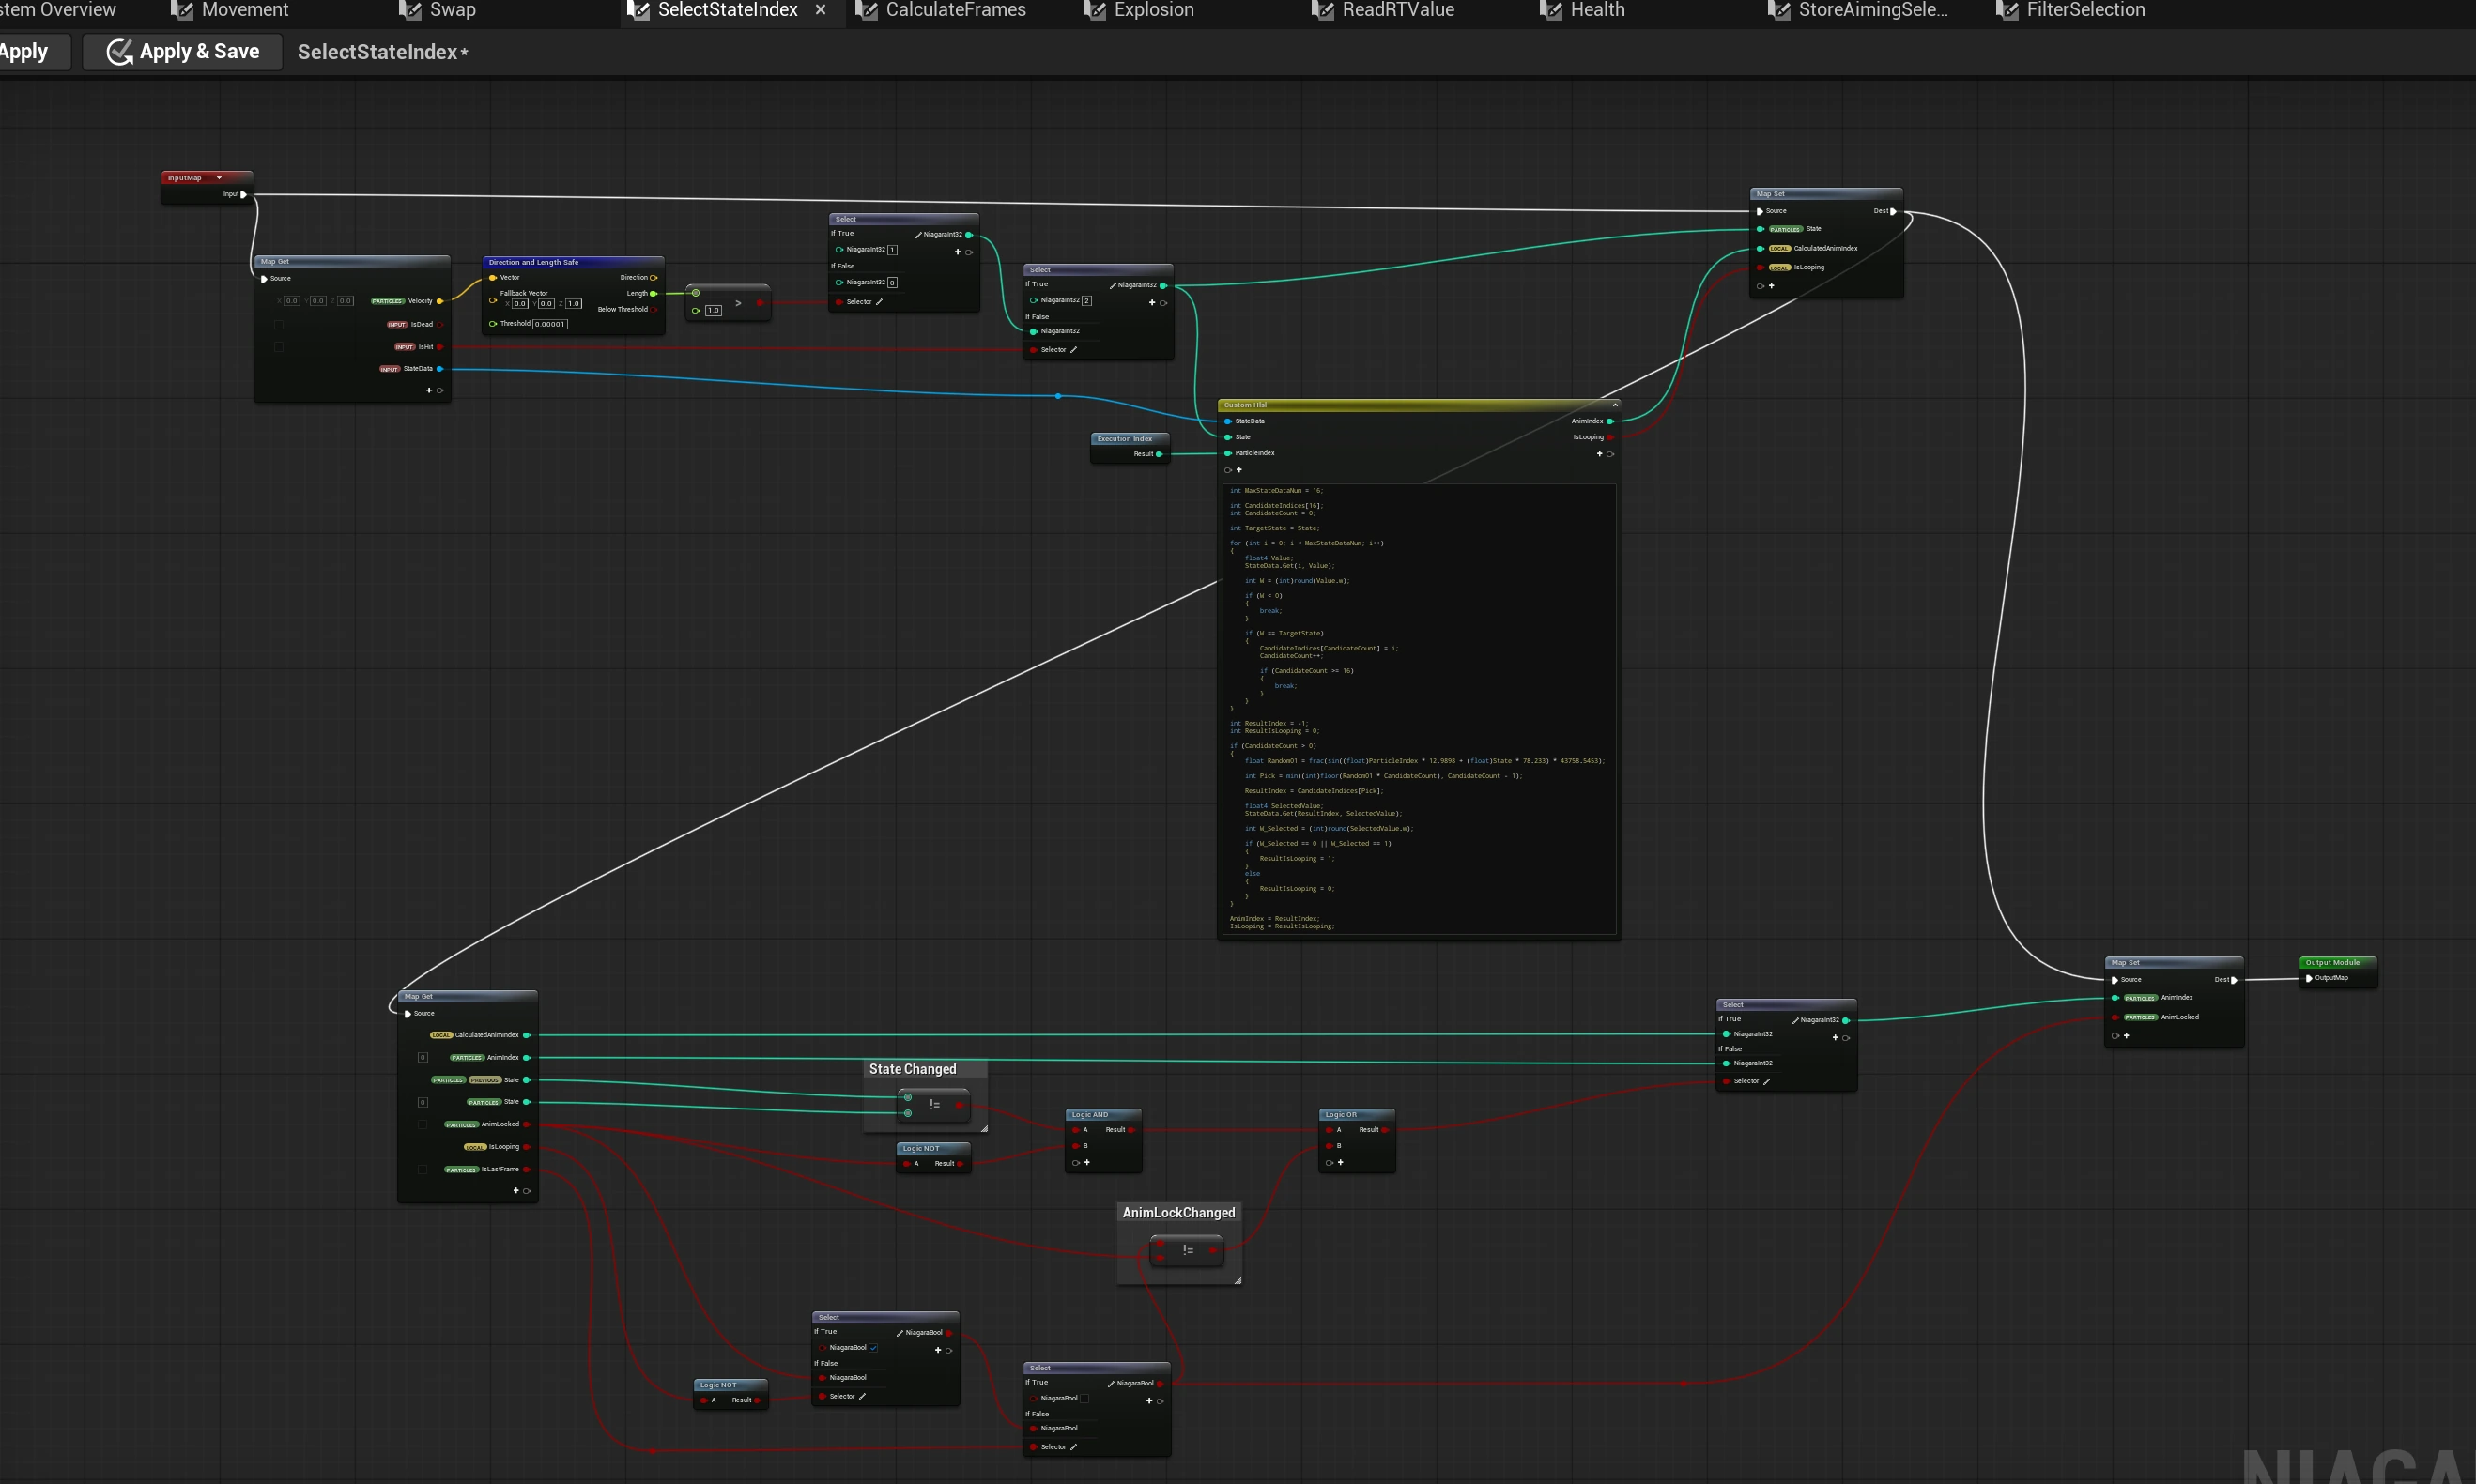
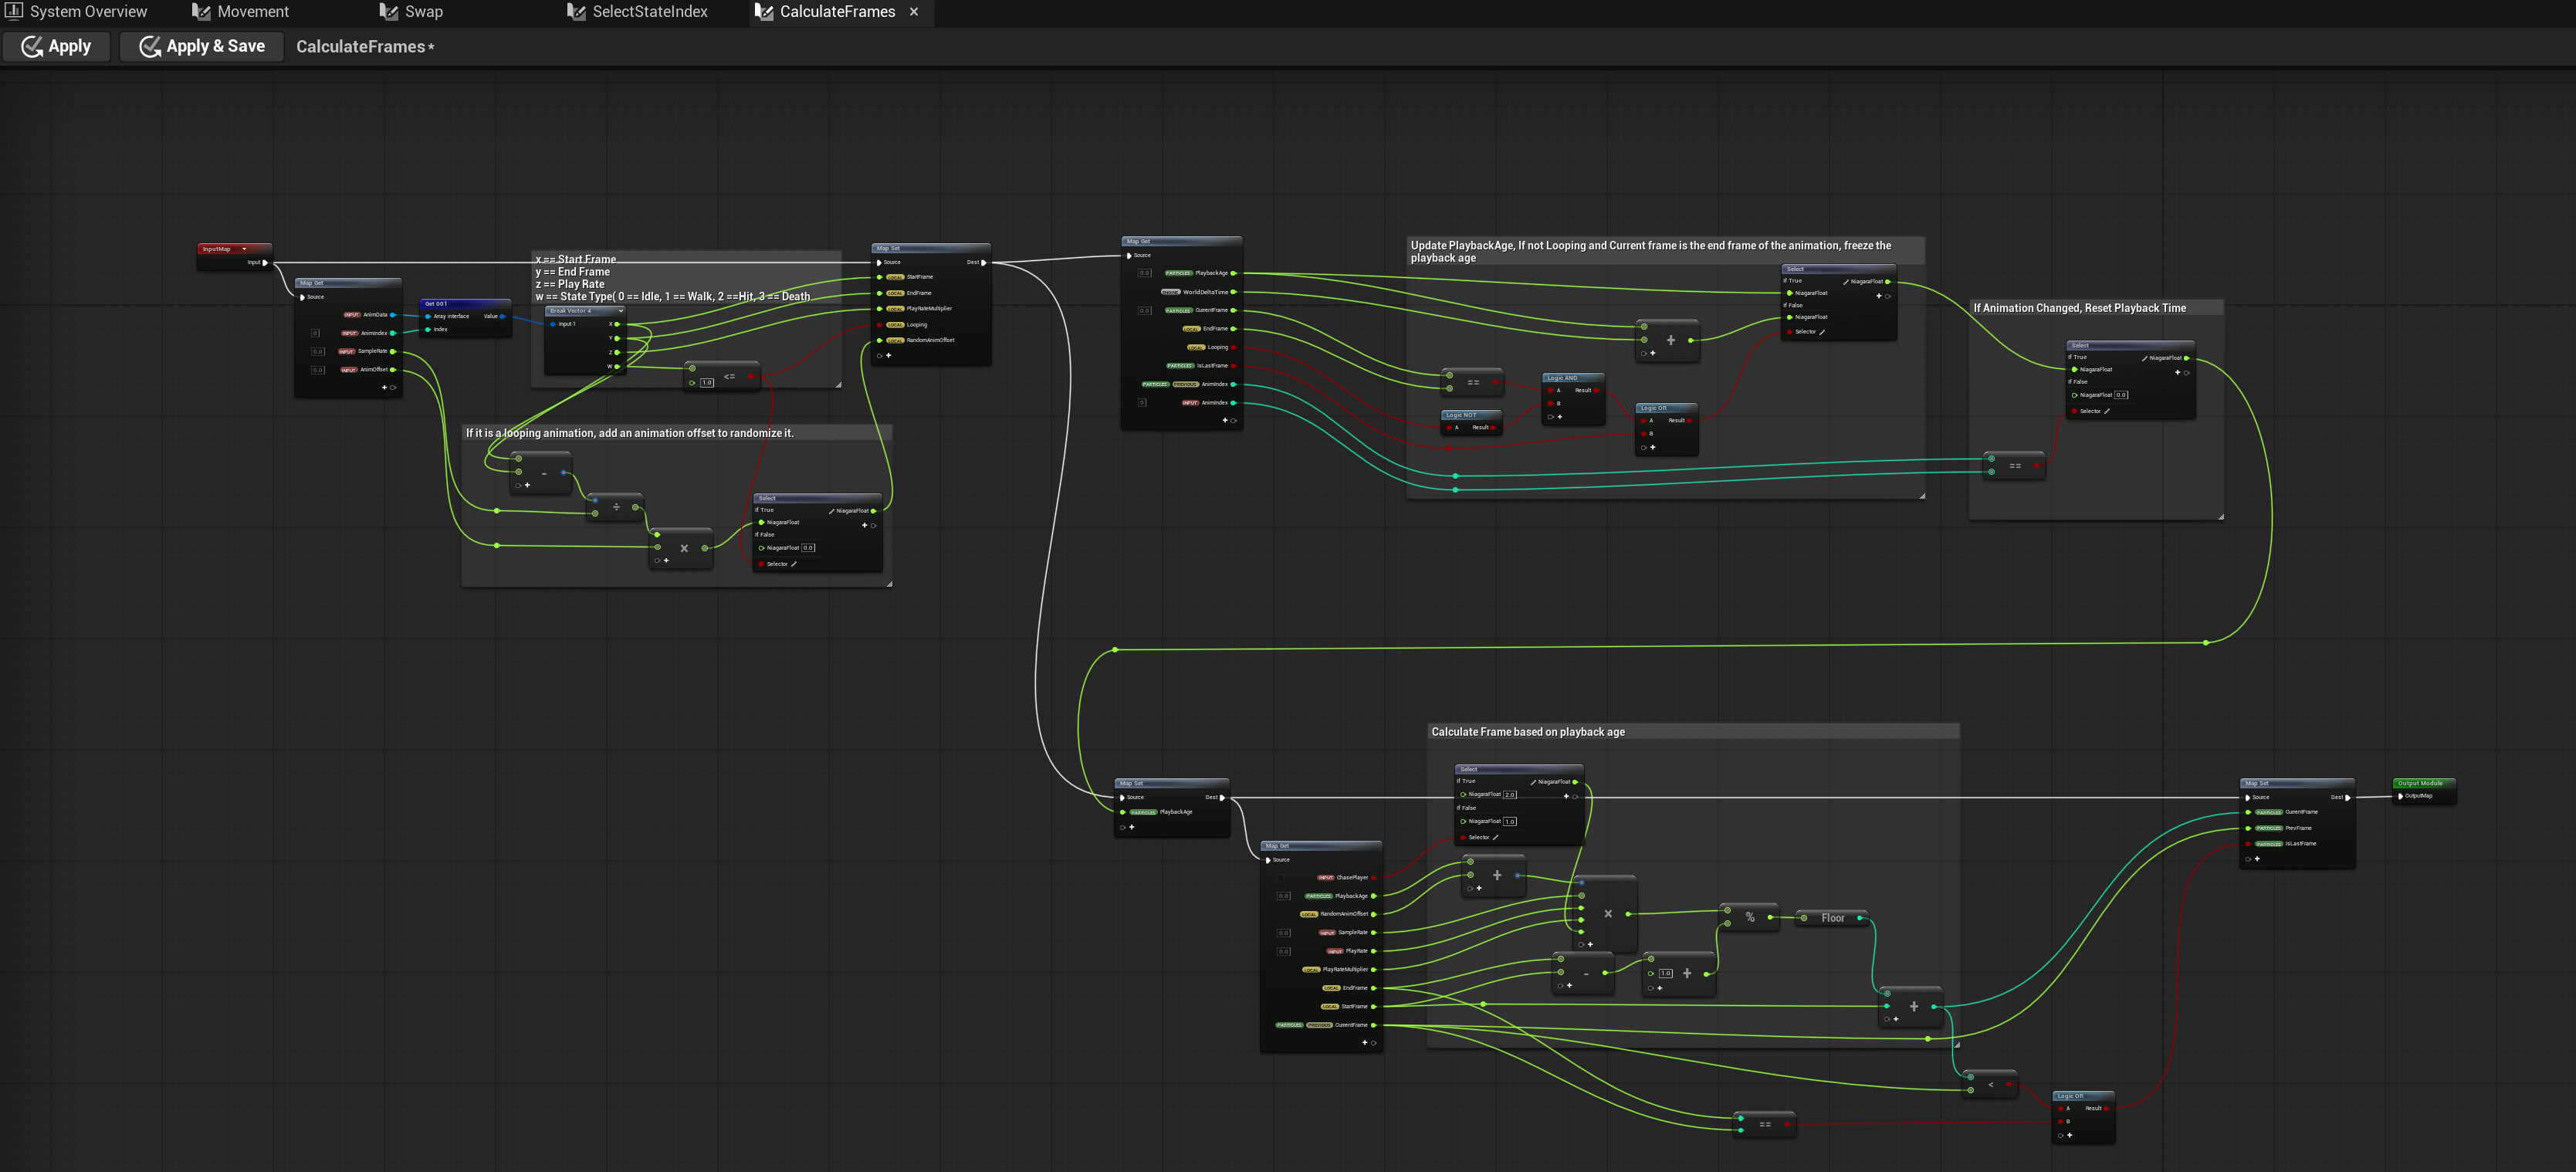
通过 AnimToTexture 烘焙 Idle、Walk、Hit 和 Death。每个 GPU Agent 独立选择状态、计算播放帧,再通过 Dynamic Parameters 把当前帧传给材质。
- AnimToTexture
- 状态数据
- 选择 Index
- 计算帧
- VAT 材质
项目概览
该项目最初用于支持《龙骑士》原型,随后从单一虫群特效扩展为一套可复用的实时 Agent 系统。系统将 VAT 动画、Neighbor Grid3D 邻居查询、粒子级伤害、Render Target 区域交互以及 GPU 到 Blueprint 的表现切换整合在同一套流程中,在保持大规模群体运行效率的同时,提供清晰的受击与死亡反馈。
系统拆解
整个系统由四部分连接起来:粒子动画、空间查询、伤害交互,以及需要物理反馈时的 GPU 到 CPU 切换。
学习参考系统中的多项基础方法参考了 Ghislain Girardot 的 Niagara 教程。我在此基础上完成了动画数据协议、Gameplay 逻辑、系统集成与性能分析。 Ghislain Girardot ↗
通过 AnimToTexture 烘焙 Idle、Walk、Hit 和 Death。每个 GPU Agent 独立选择状态、计算播放帧,再通过 Dynamic Parameters 把当前帧传给材质。
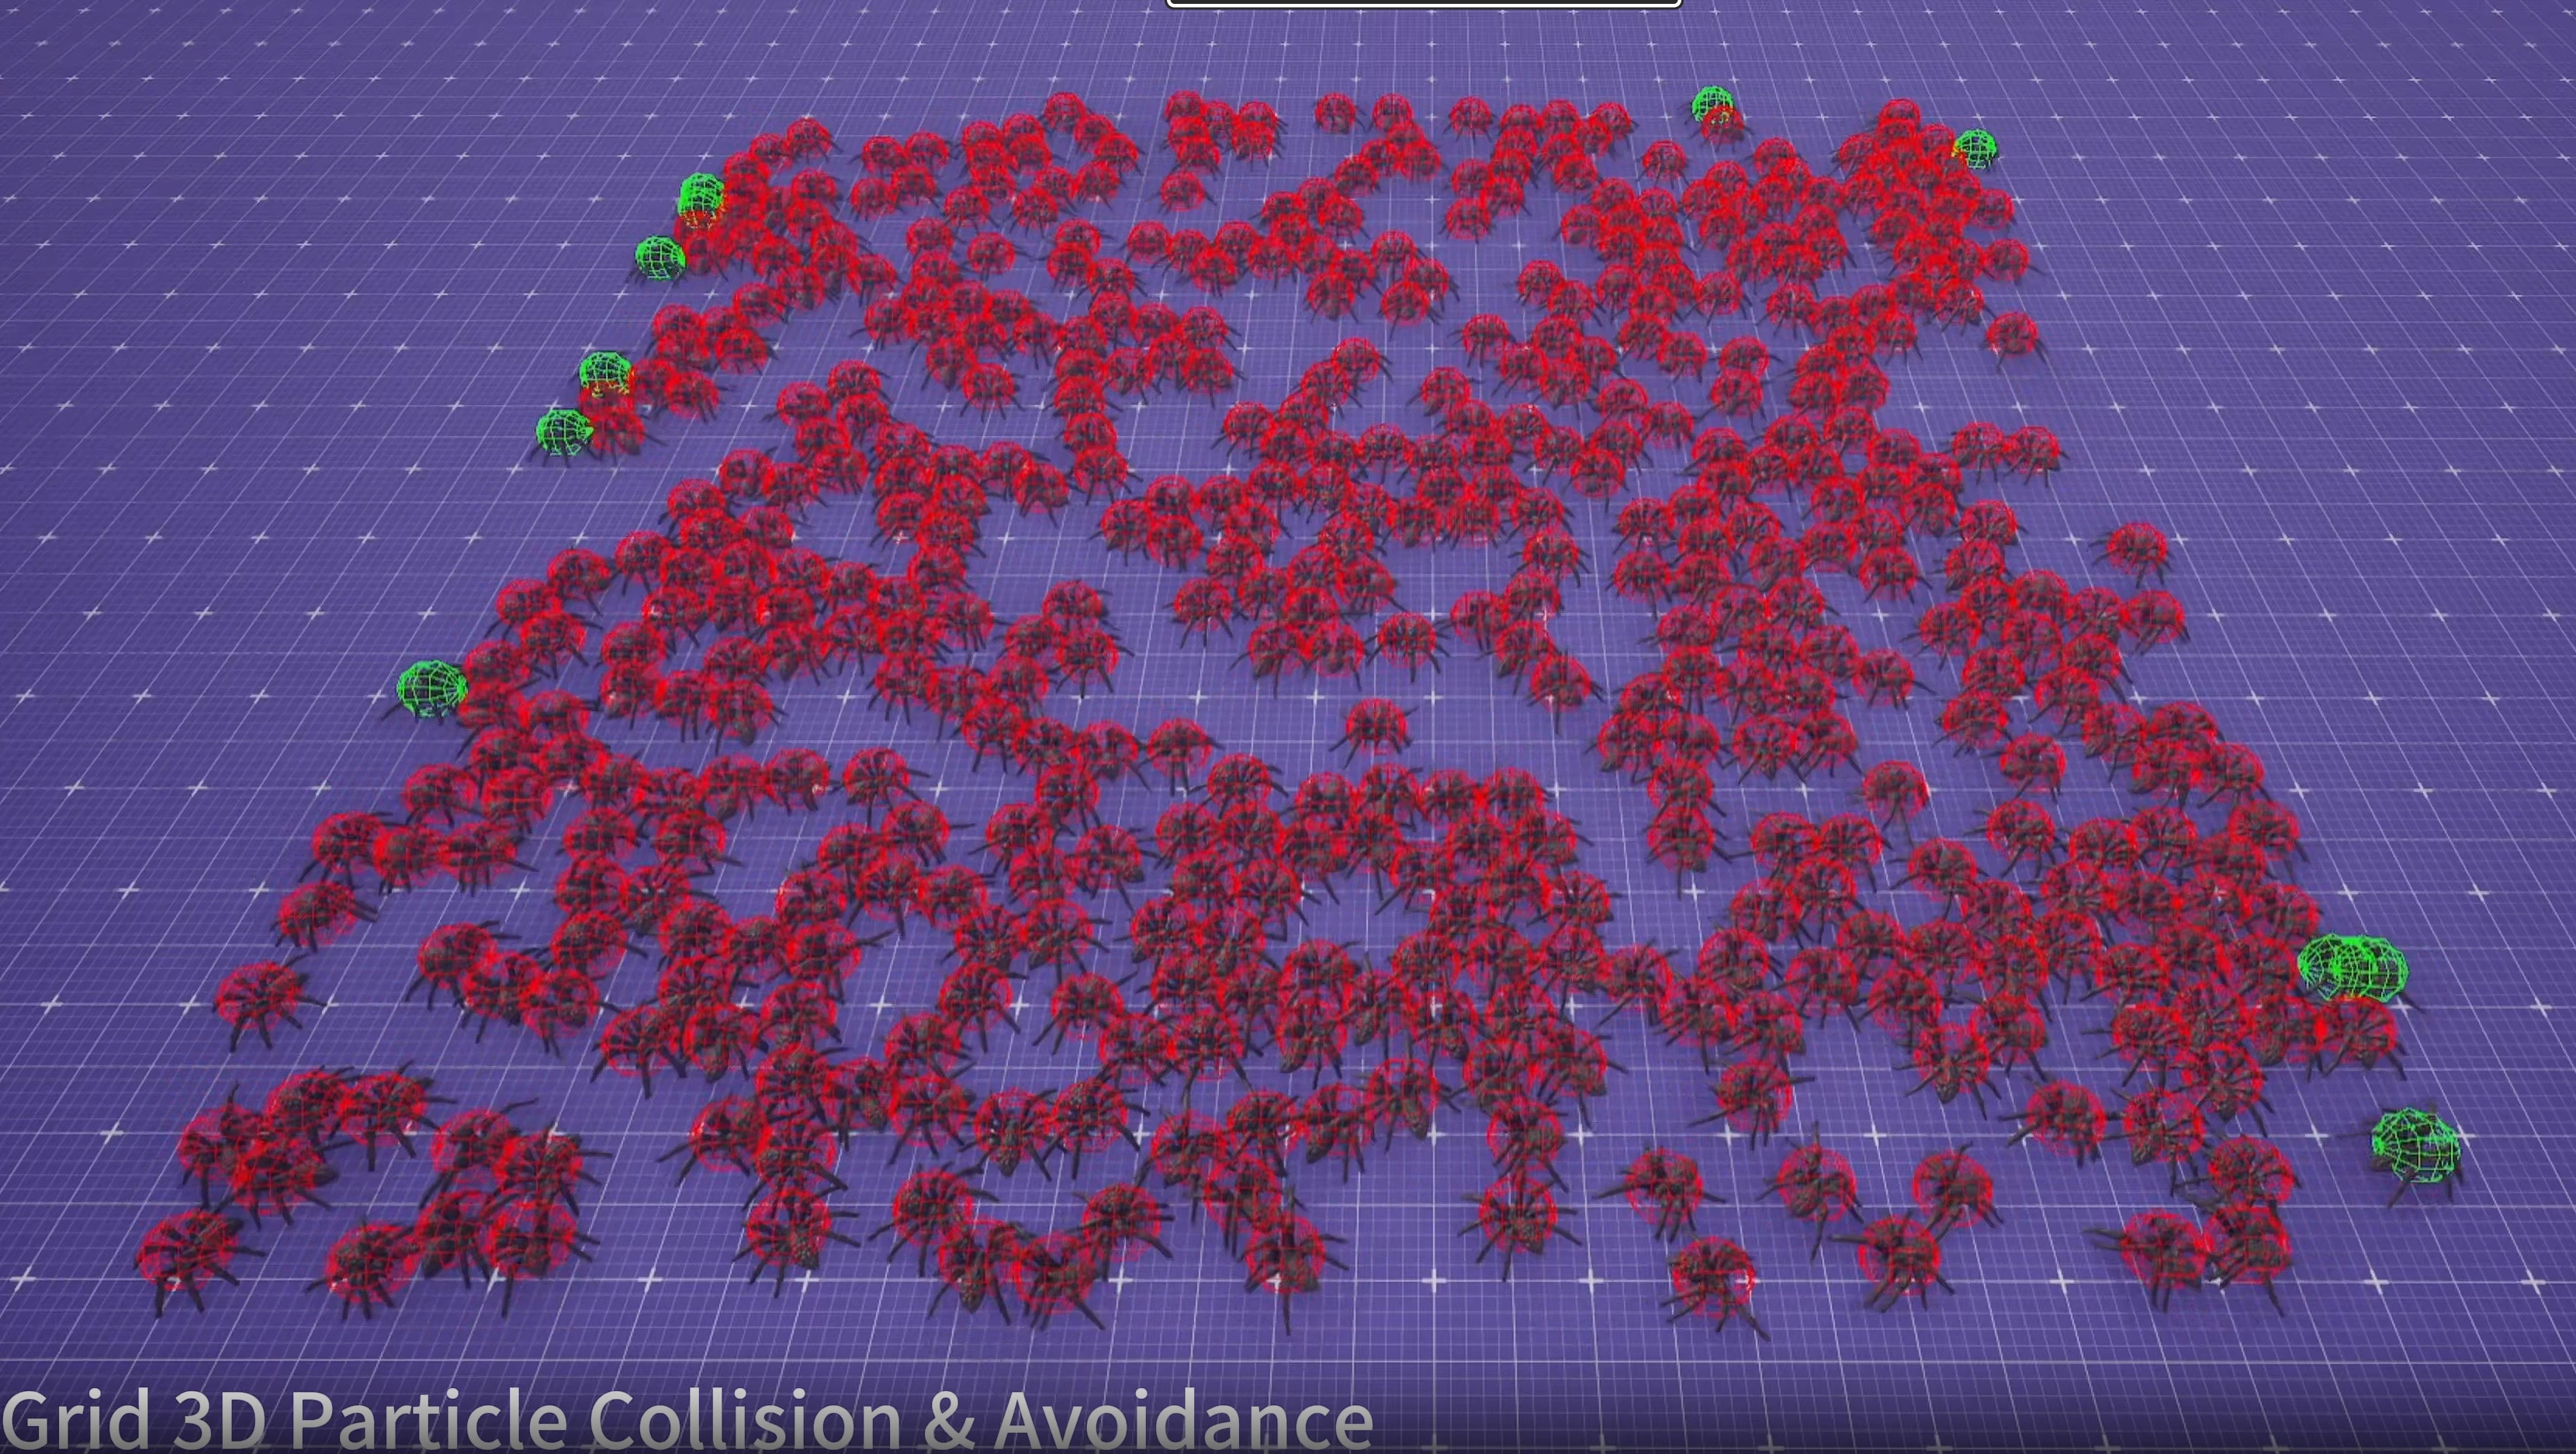
Agent 先把位置写入 3D Grid,再查询附近 Cell,用于 Separation 和局部影响。这样只需要处理邻近数据,不必让每个粒子与整个虫群逐一比较。
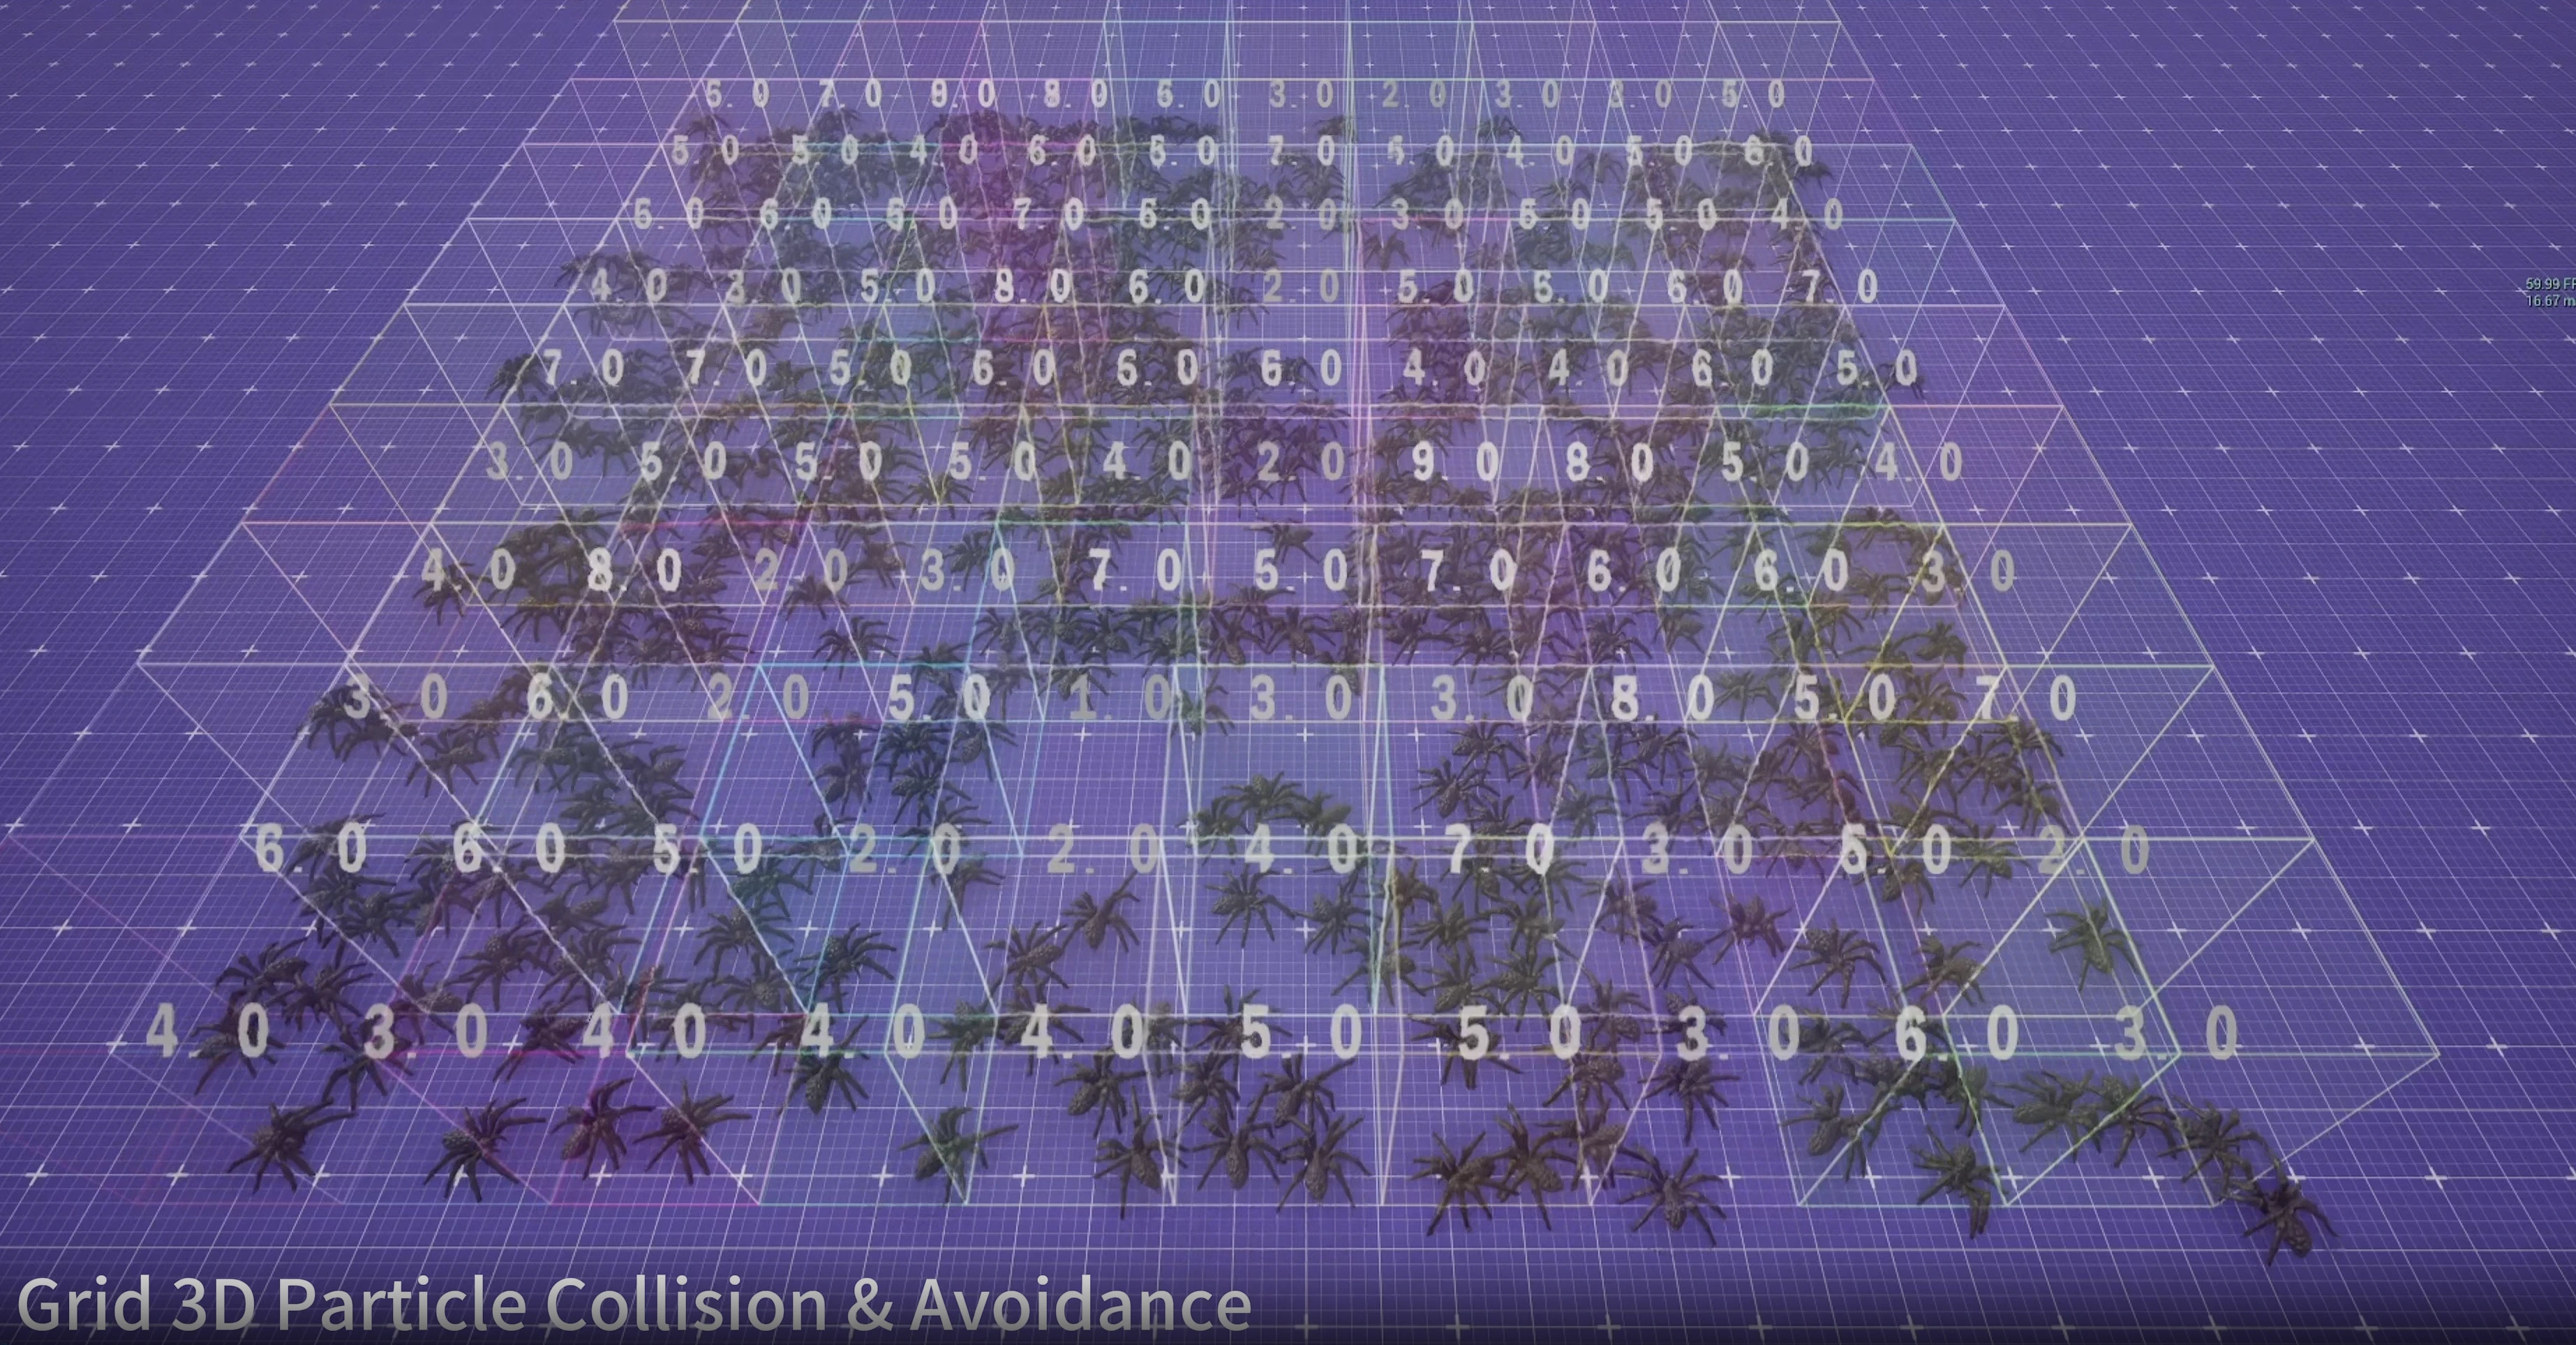
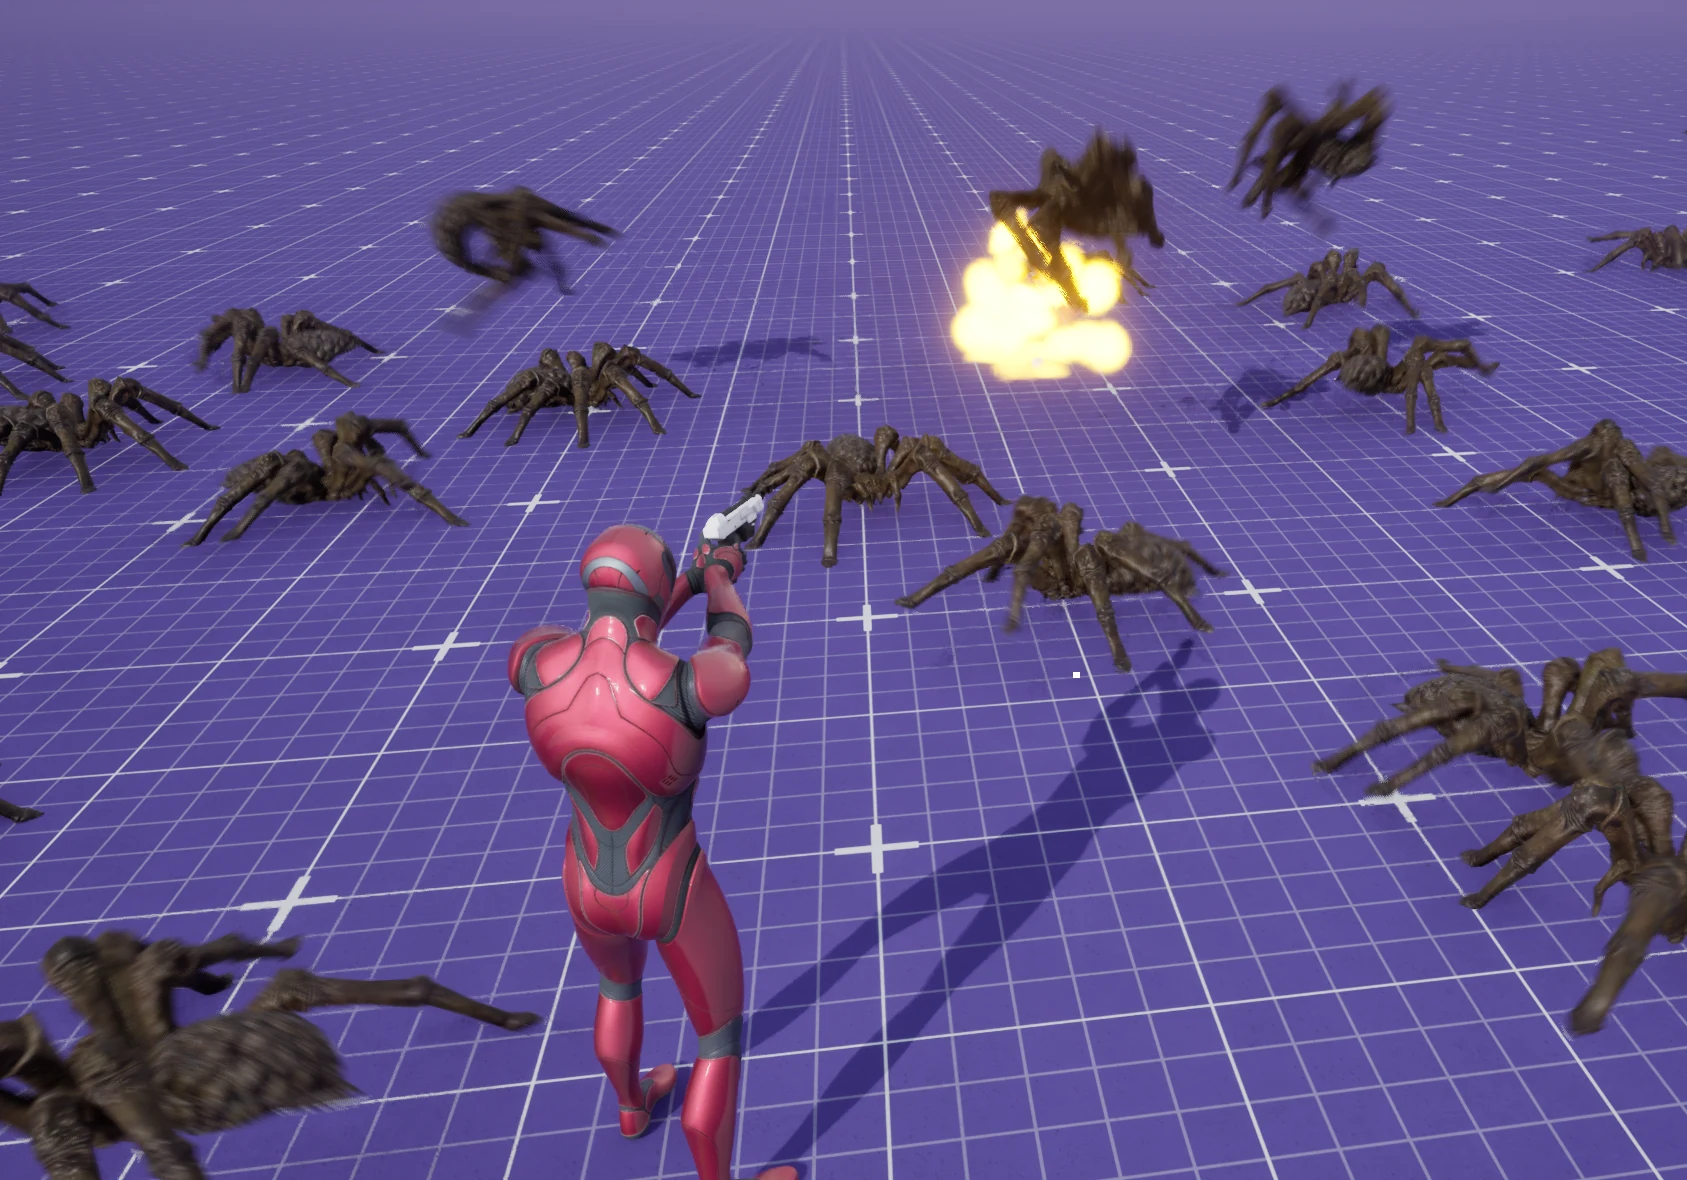
同一套生命值和状态流程可以接收三类输入:射线点射、范围爆炸,以及写入 Render Target 的持续伤害。
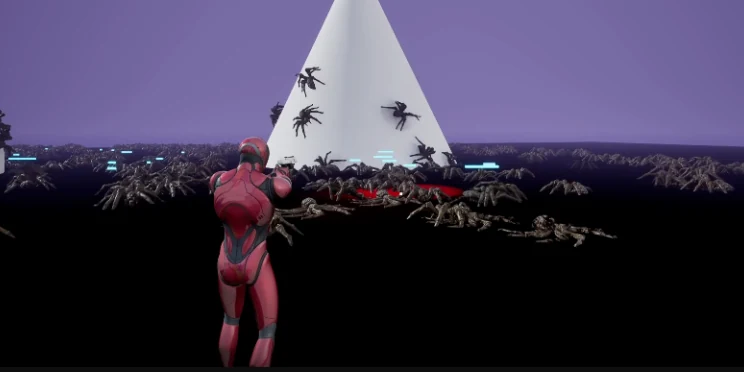
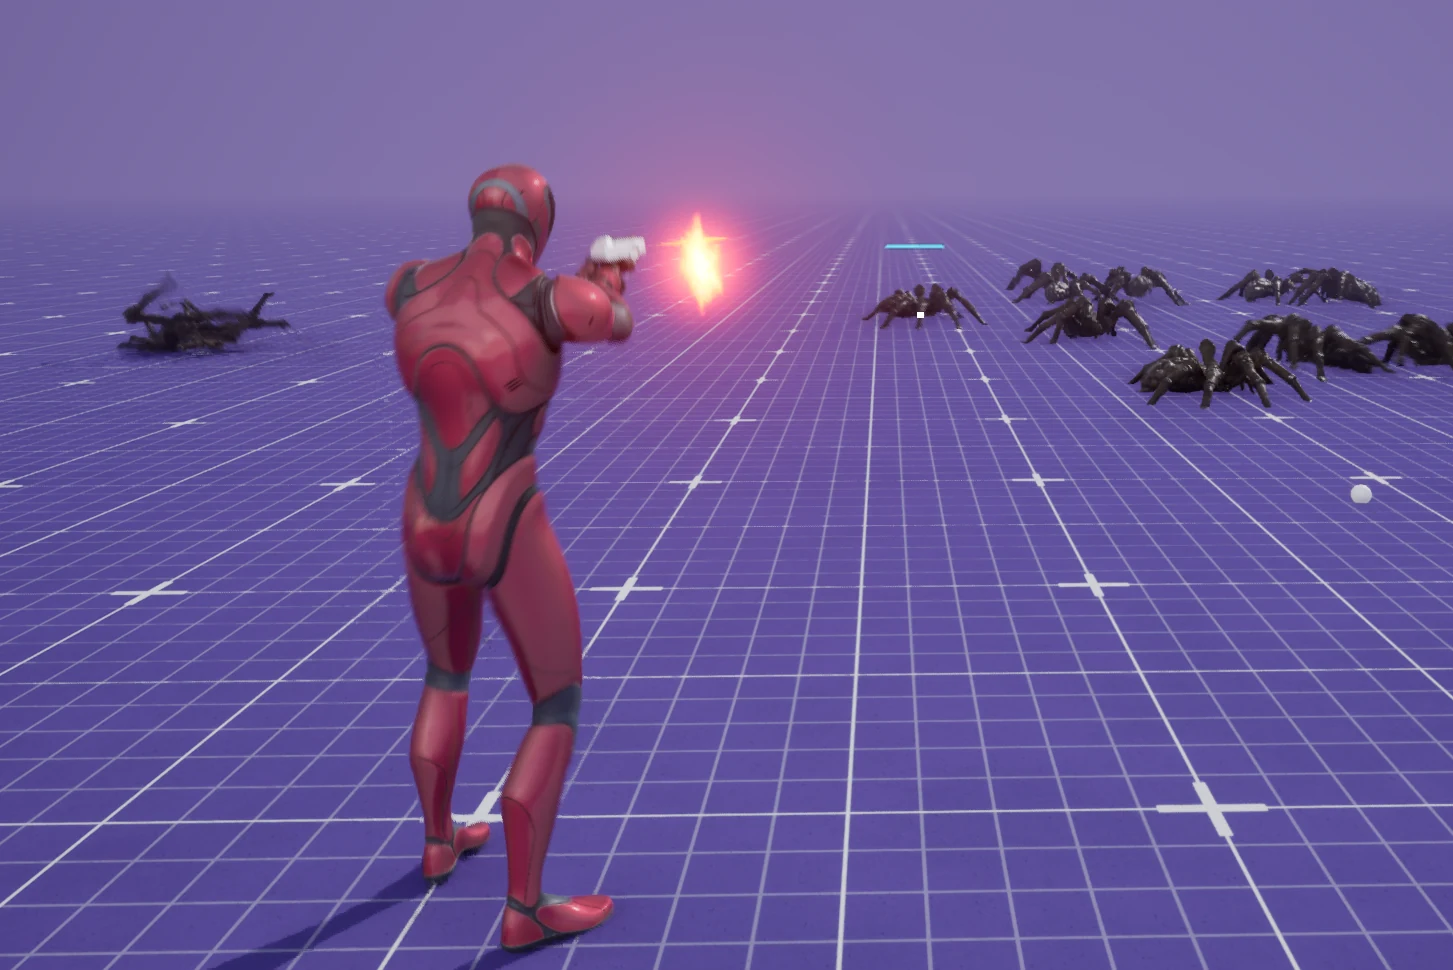
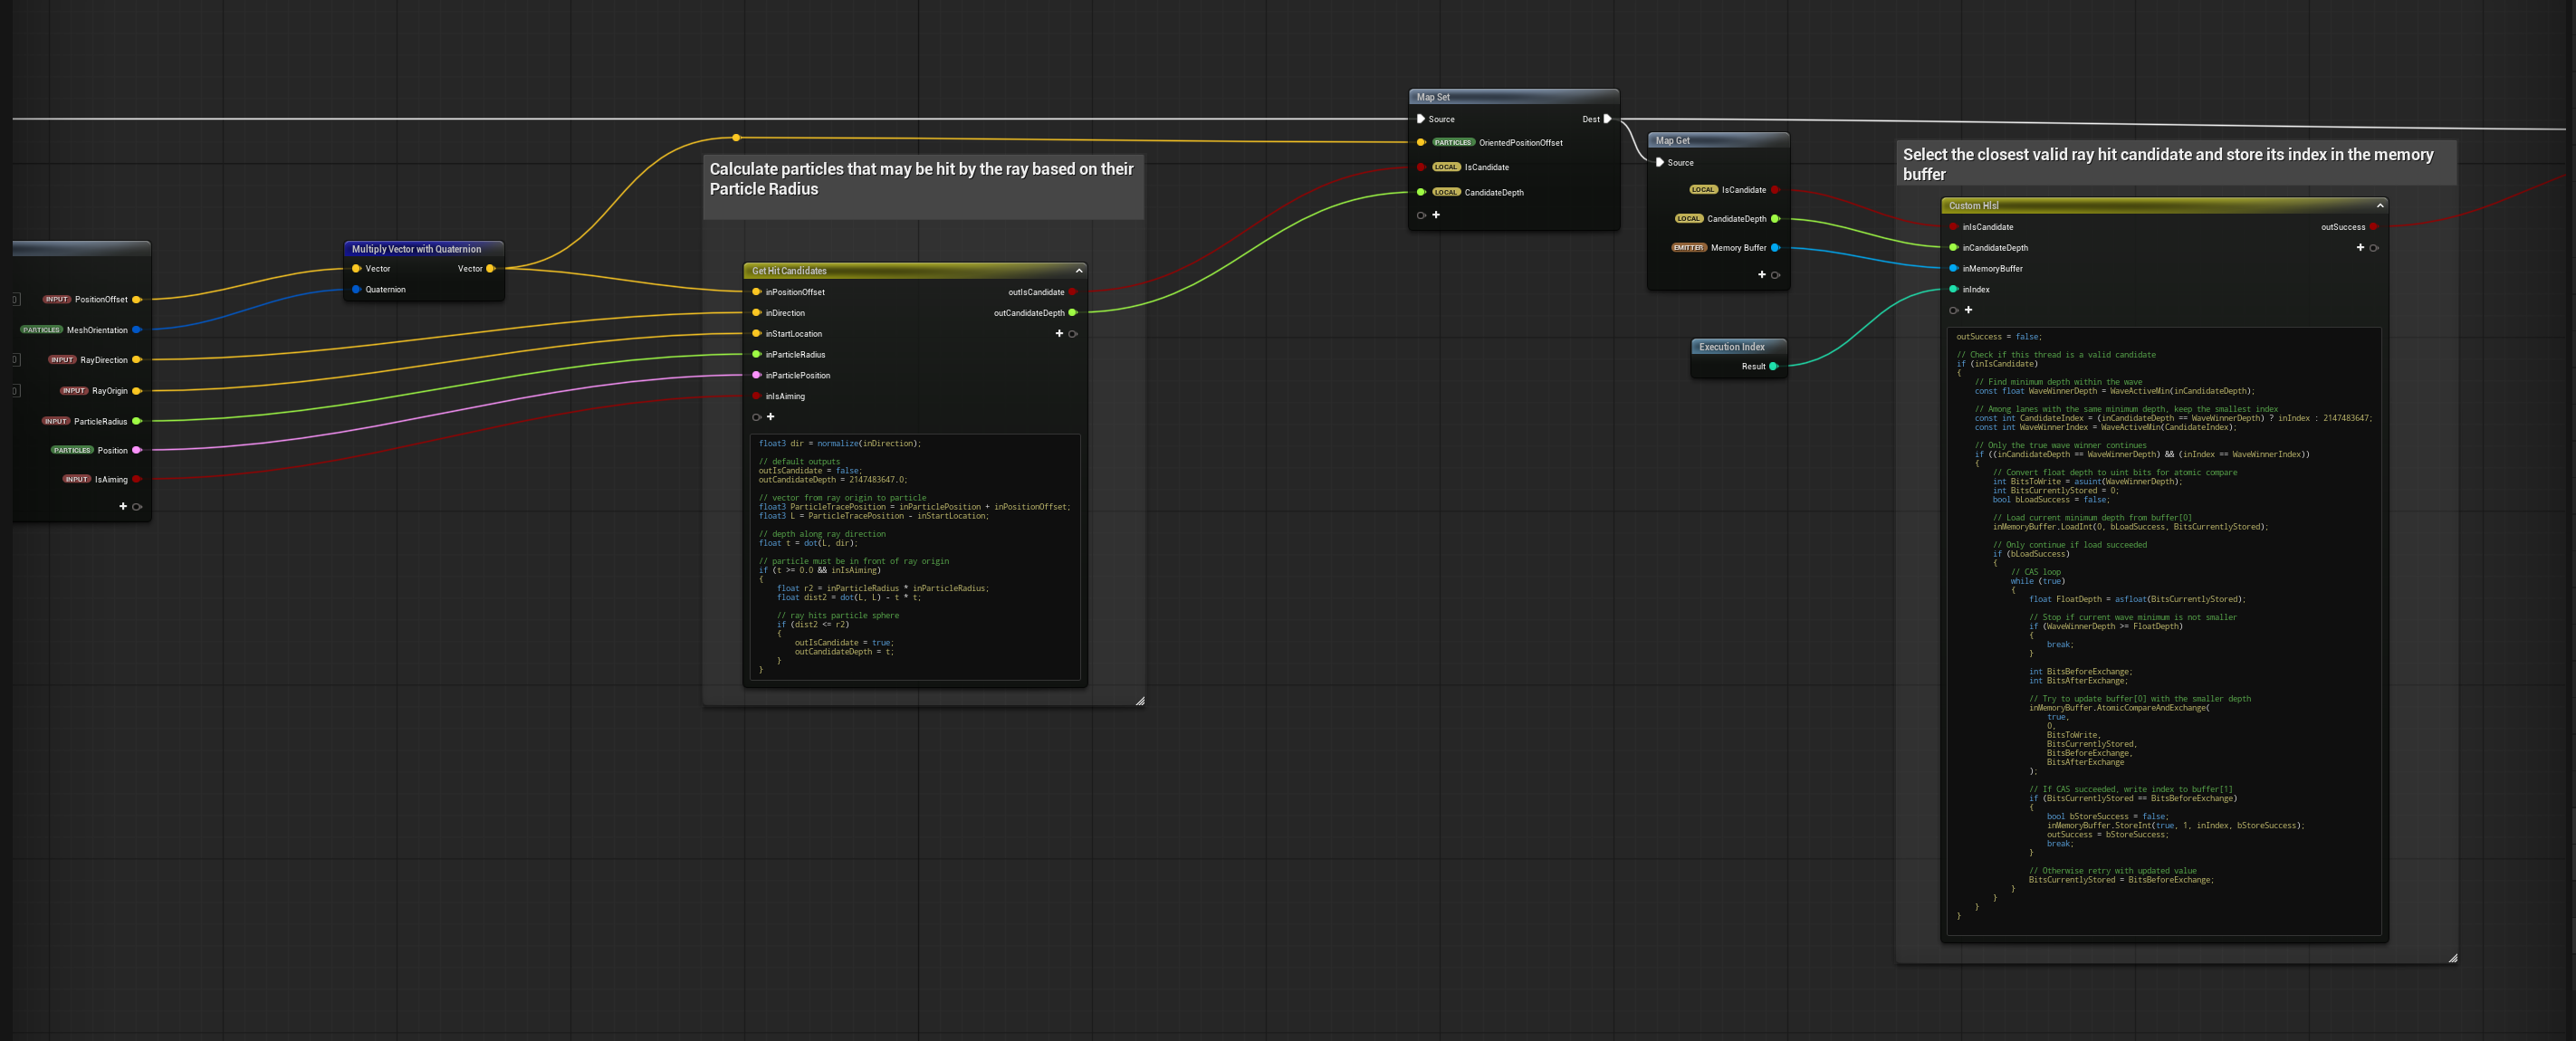
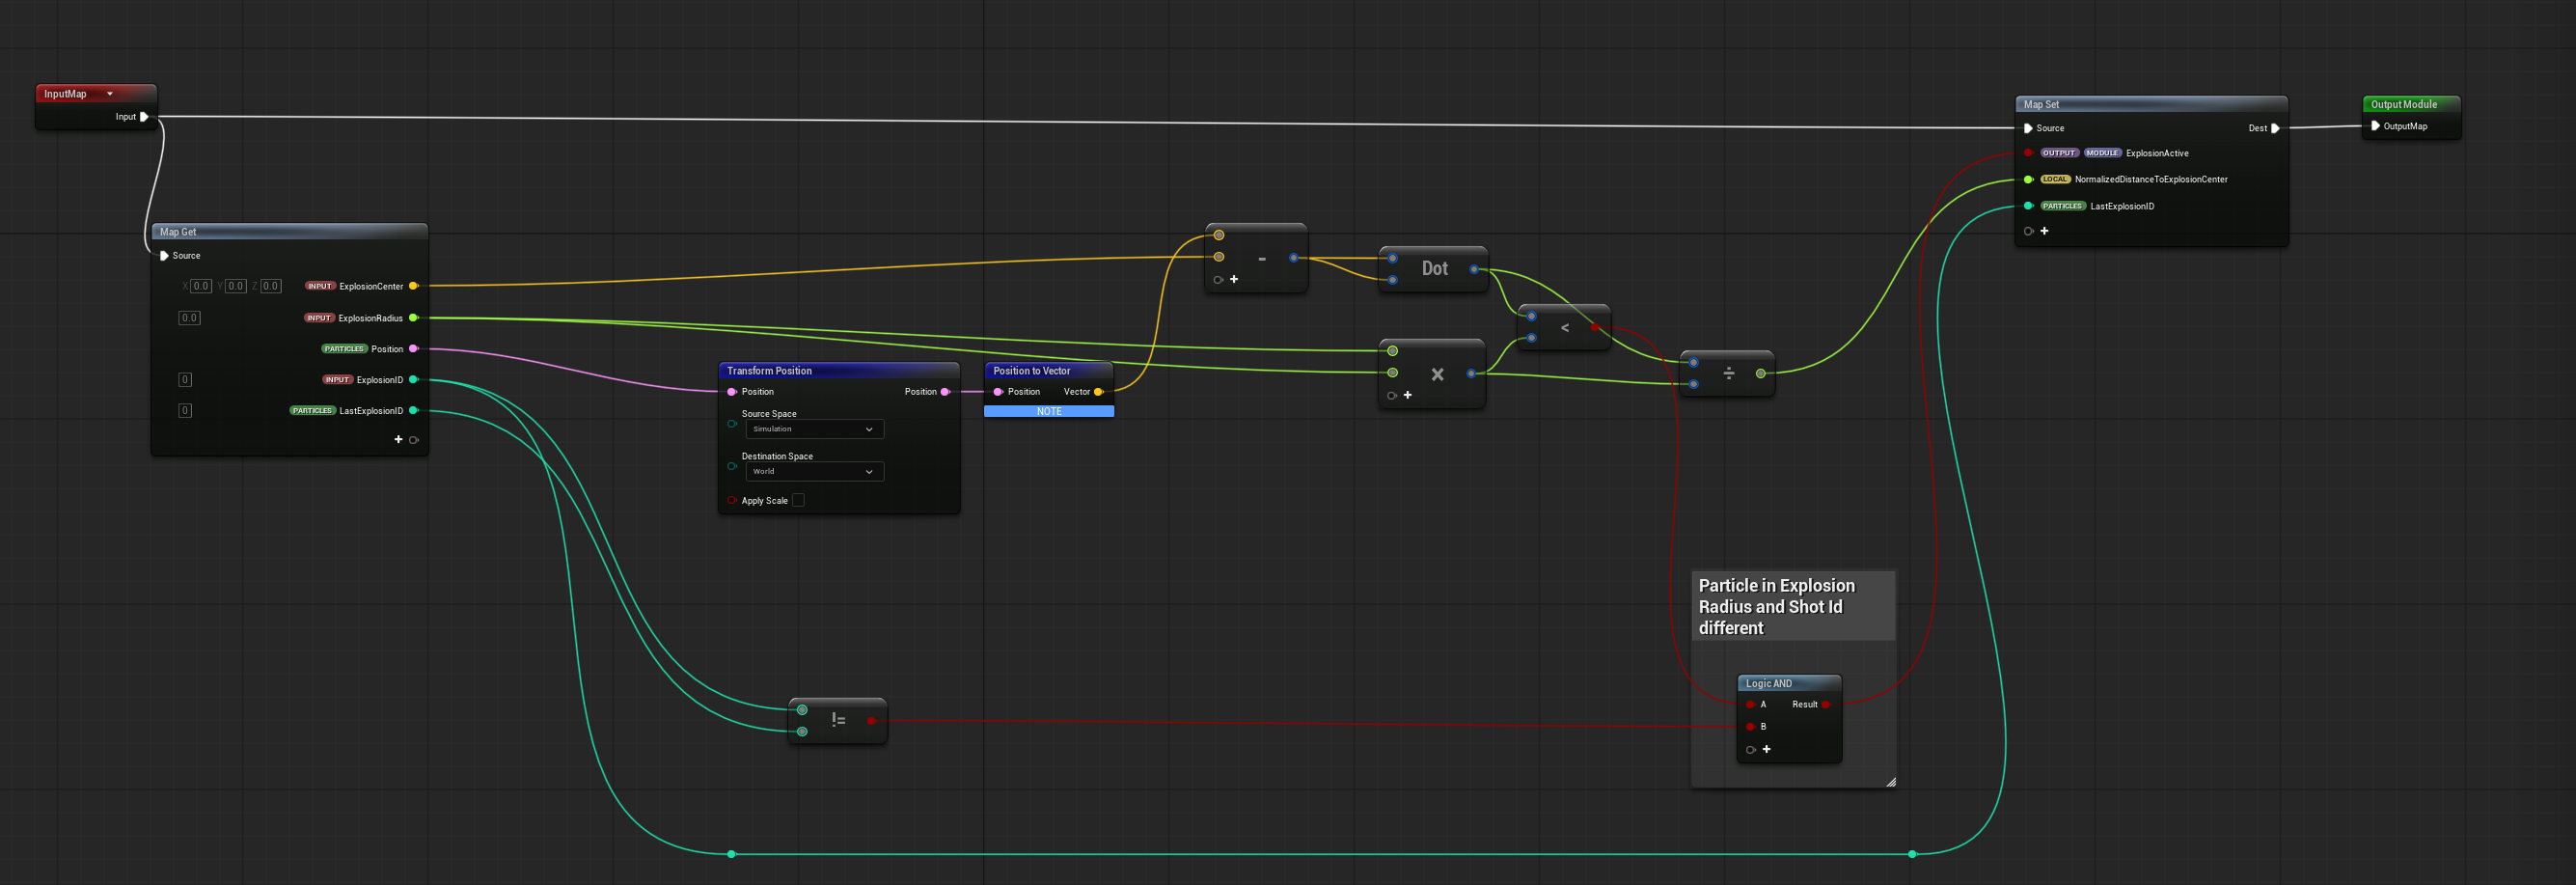
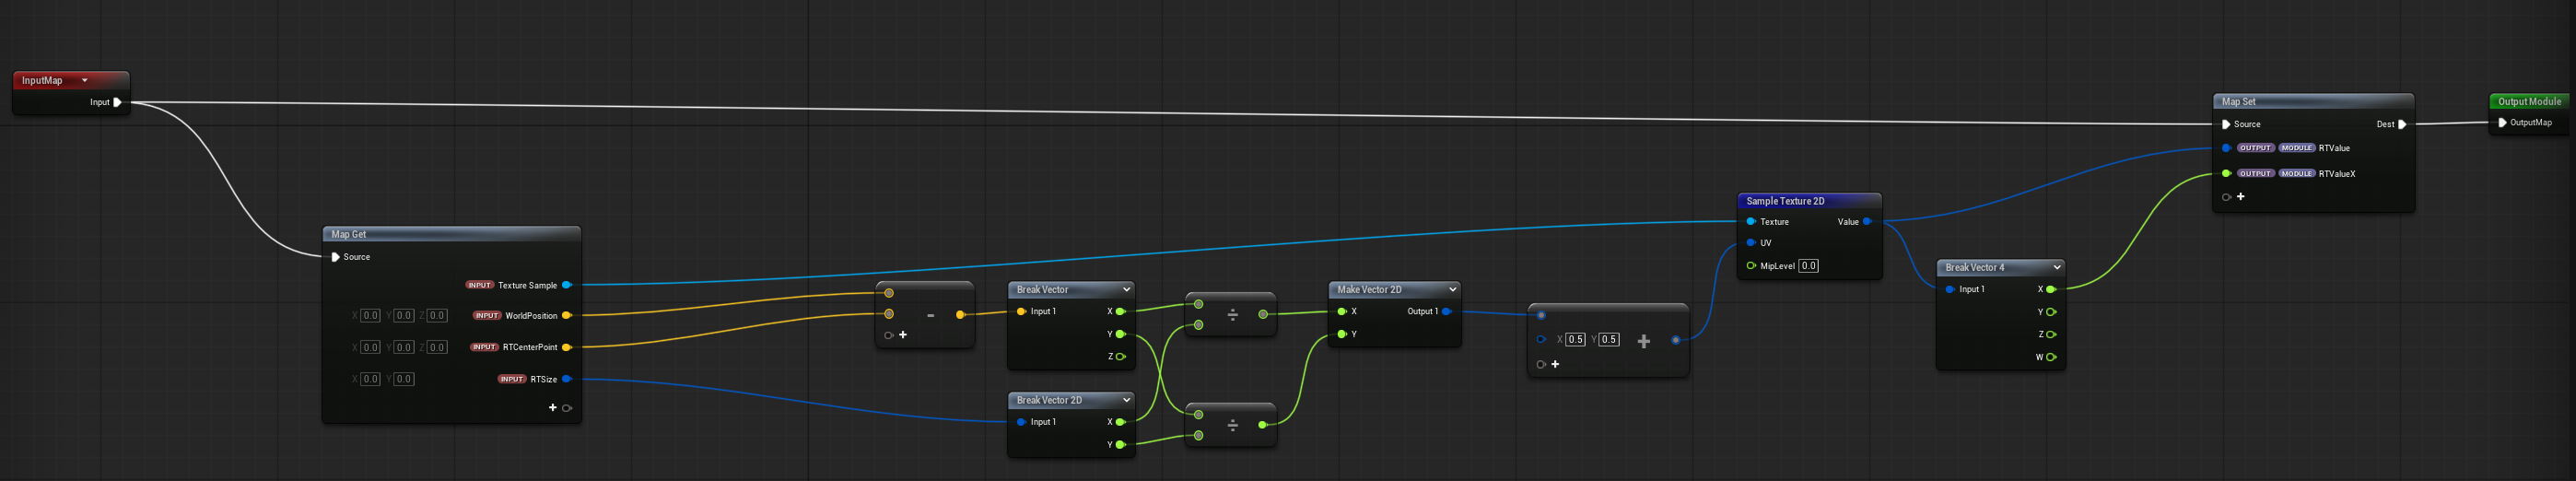
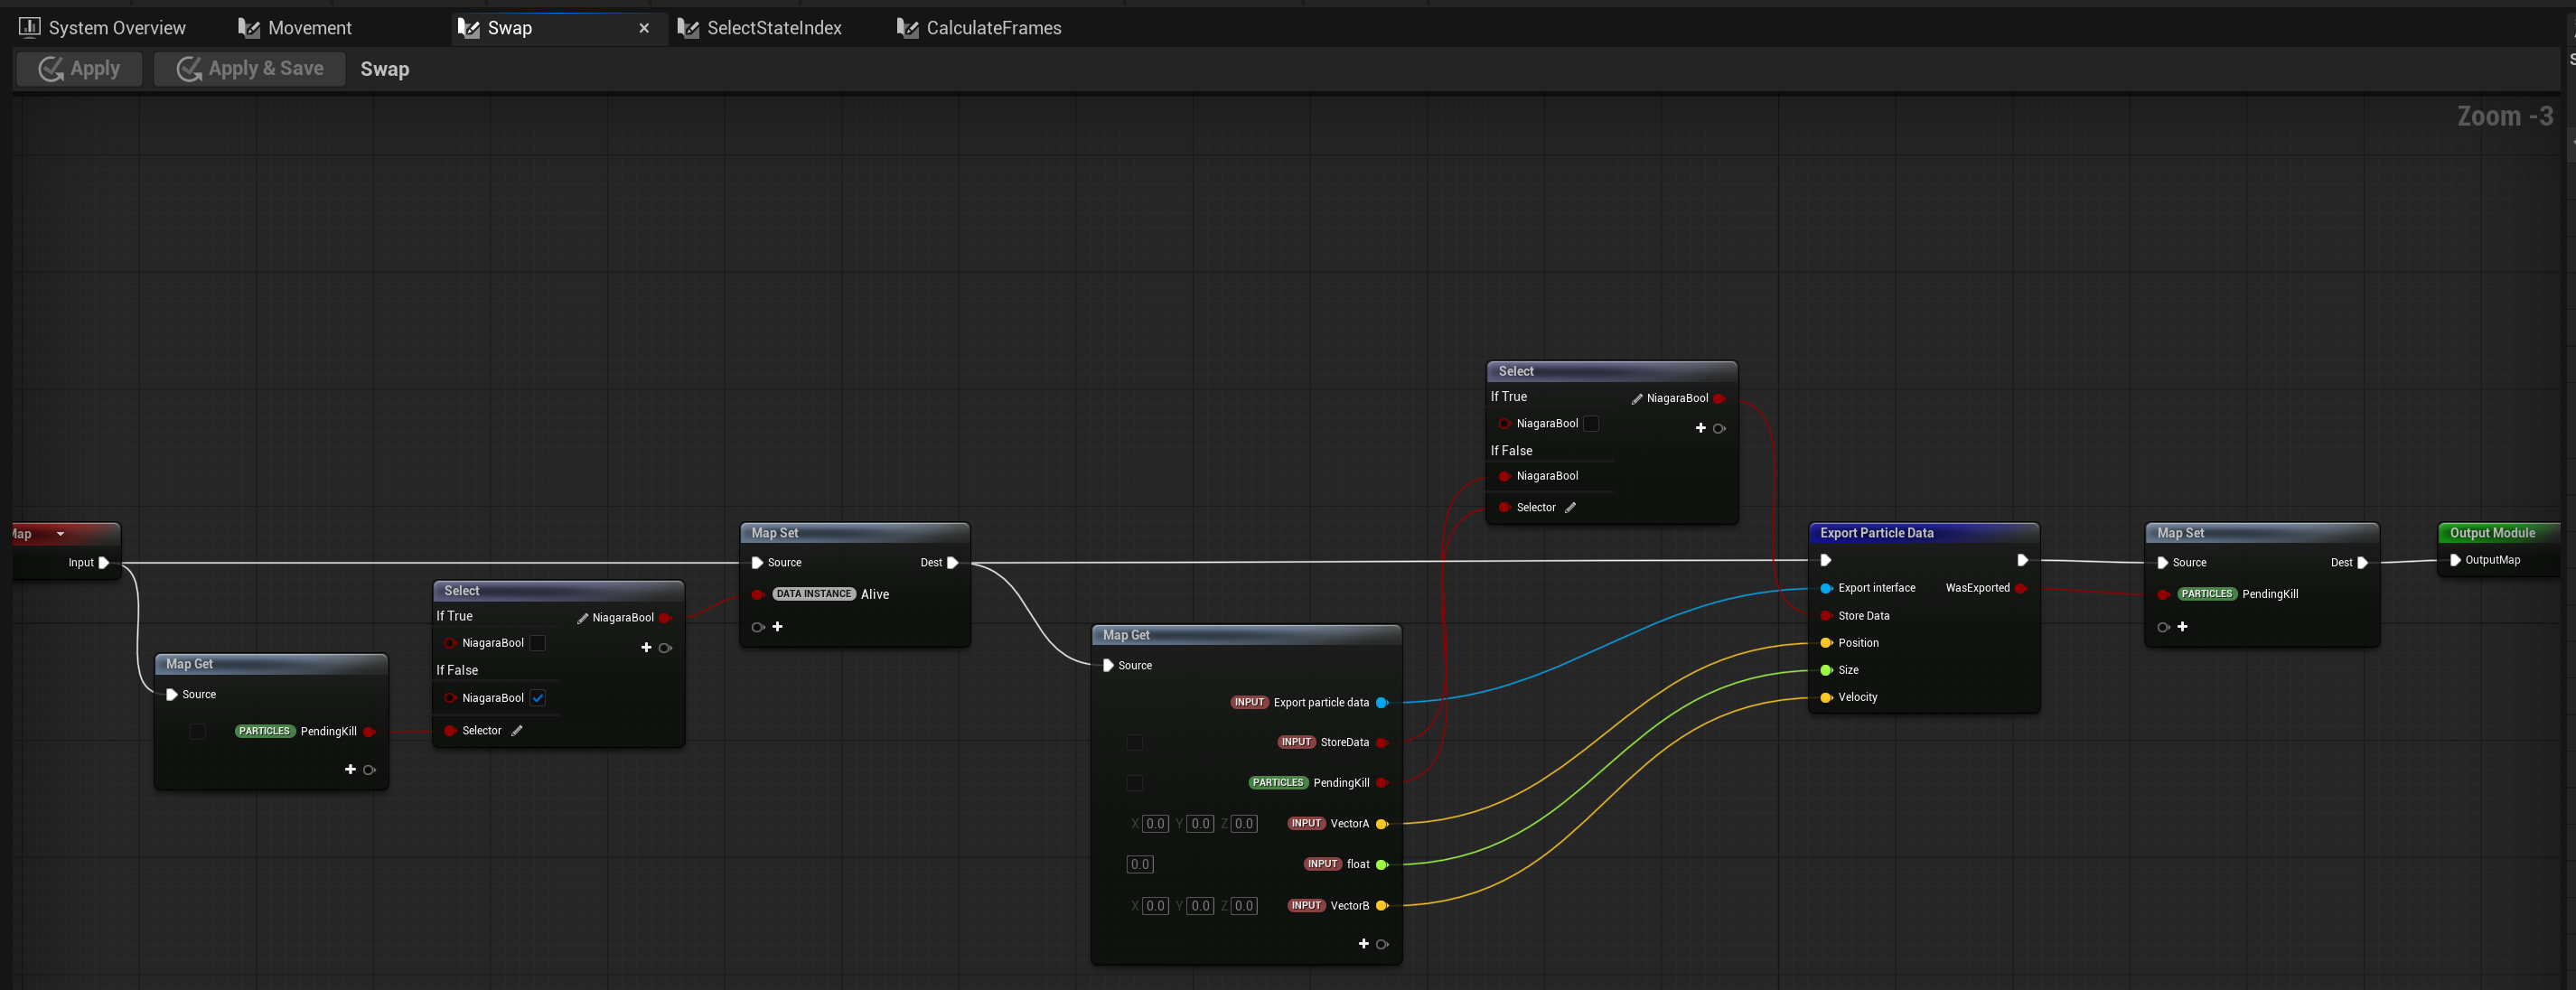
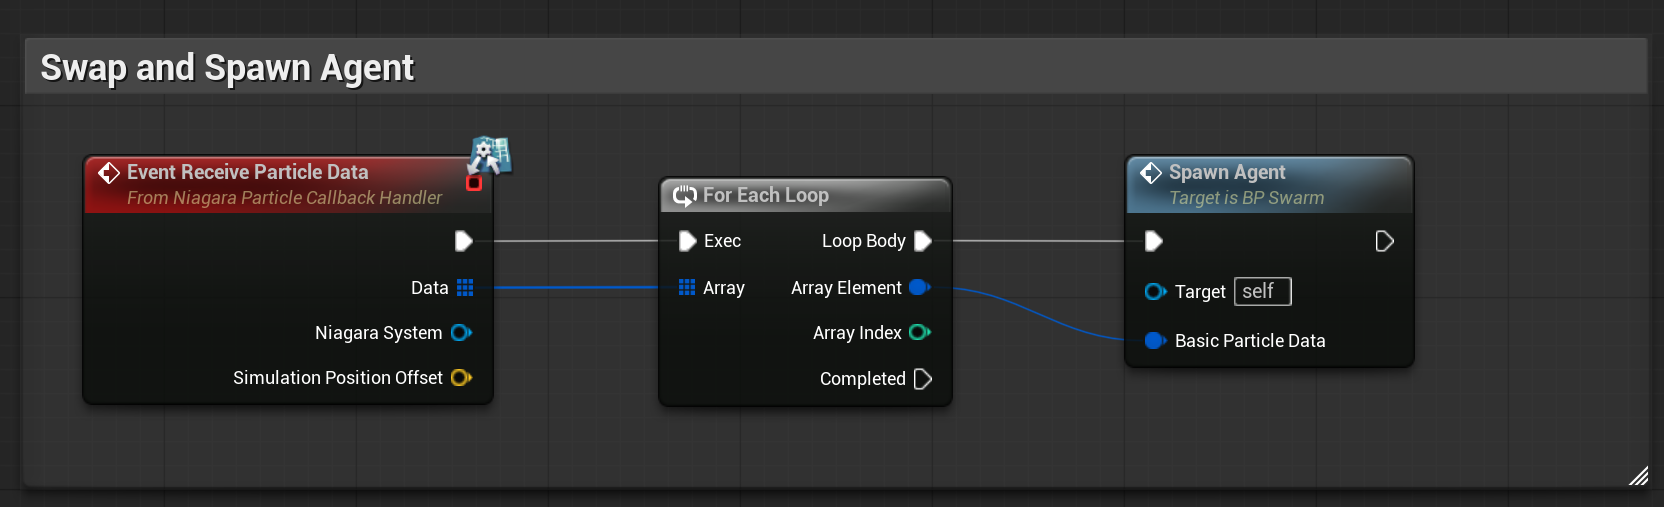
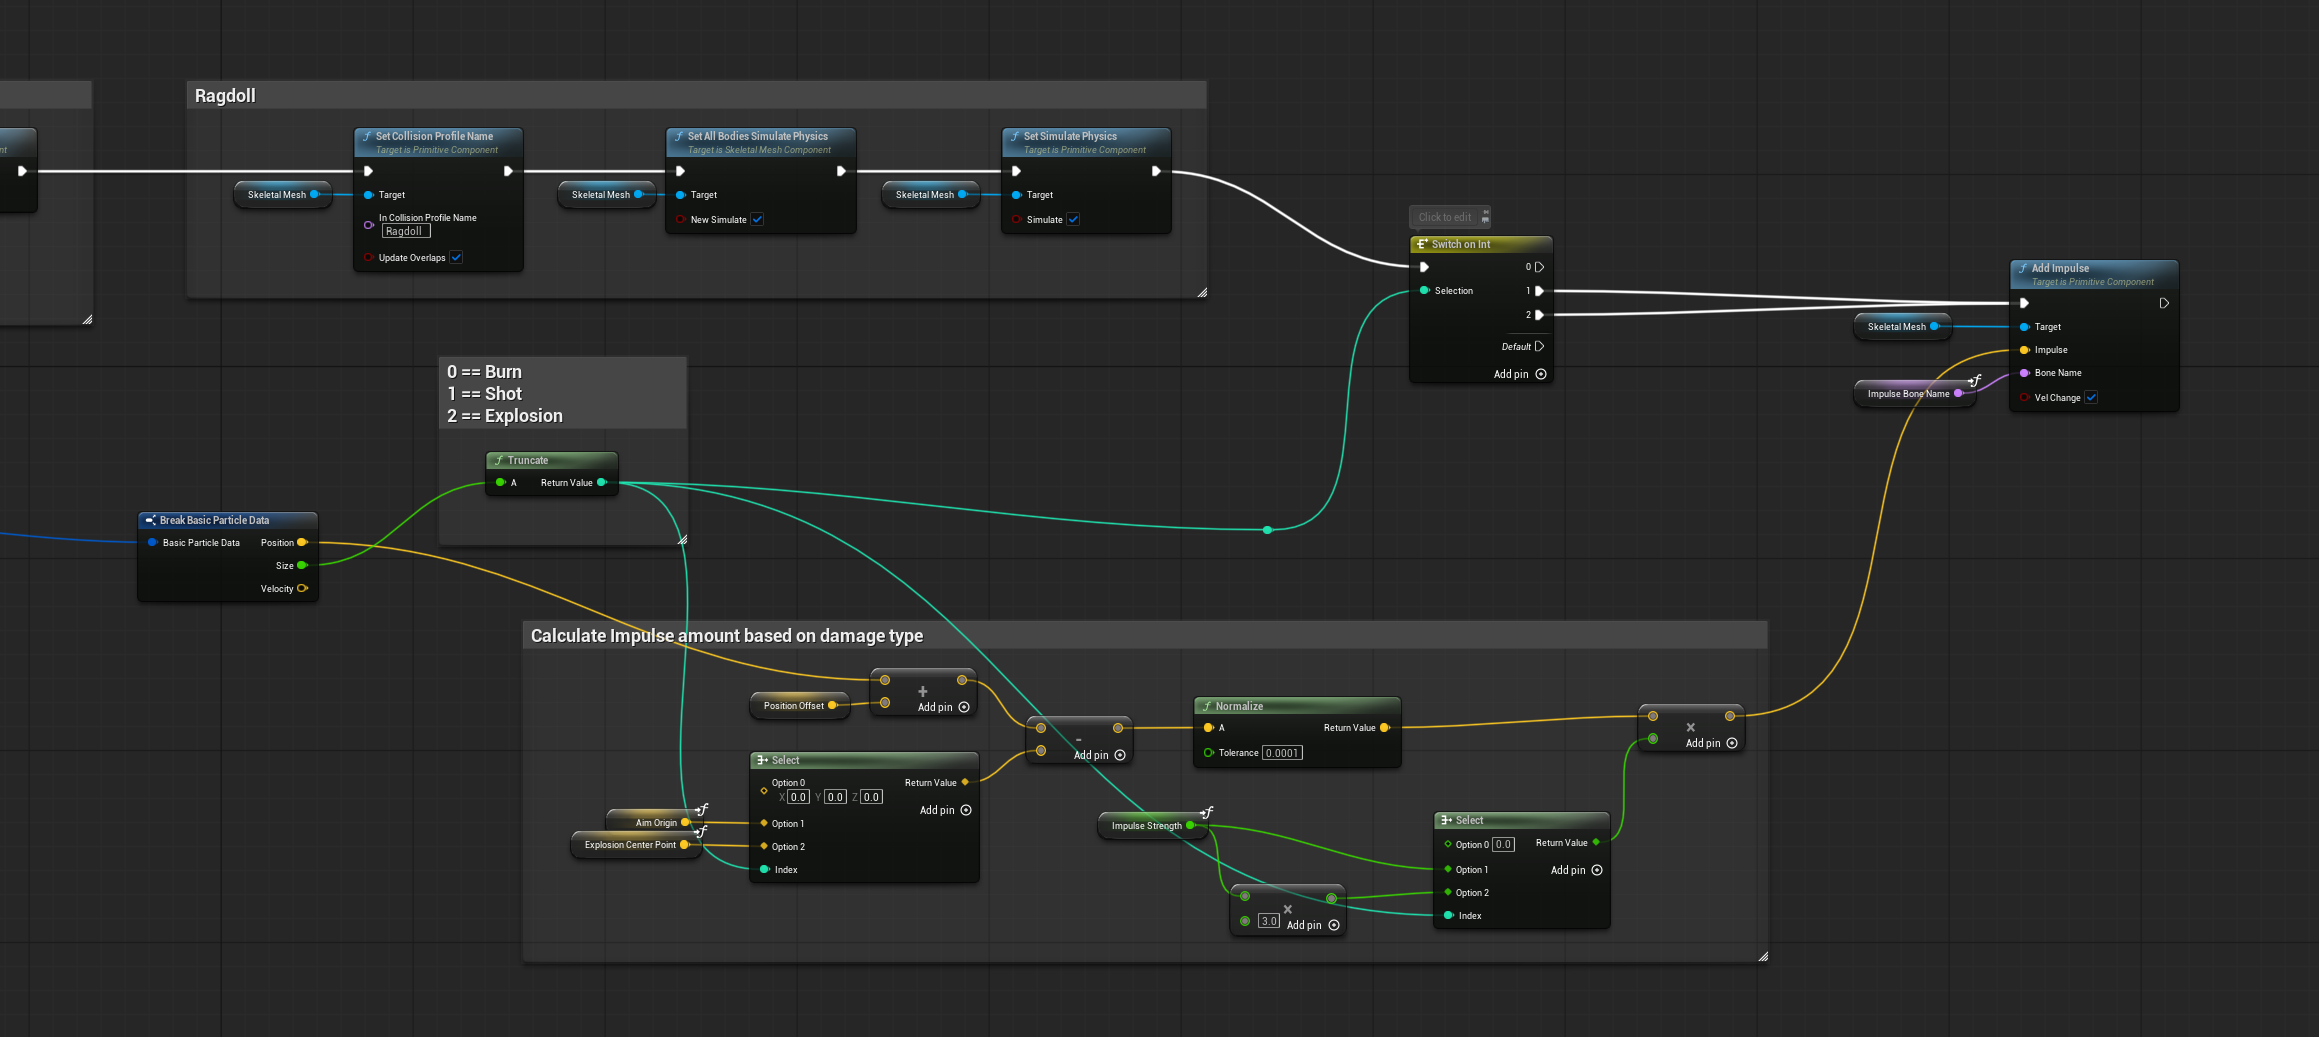
大规模群体由 GPU 粒子负责;需要细致死亡反馈时,Niagara 只导出必要数据,由 Blueprint 在同一位置生成 CPU Agent,并接管 Ragdoll 与方向性冲量。
Performance / Profiling study
先在一万个粒子下替换模型和材质,再增加粒子数量,最后查看 Niagara 内部各阶段的耗时。
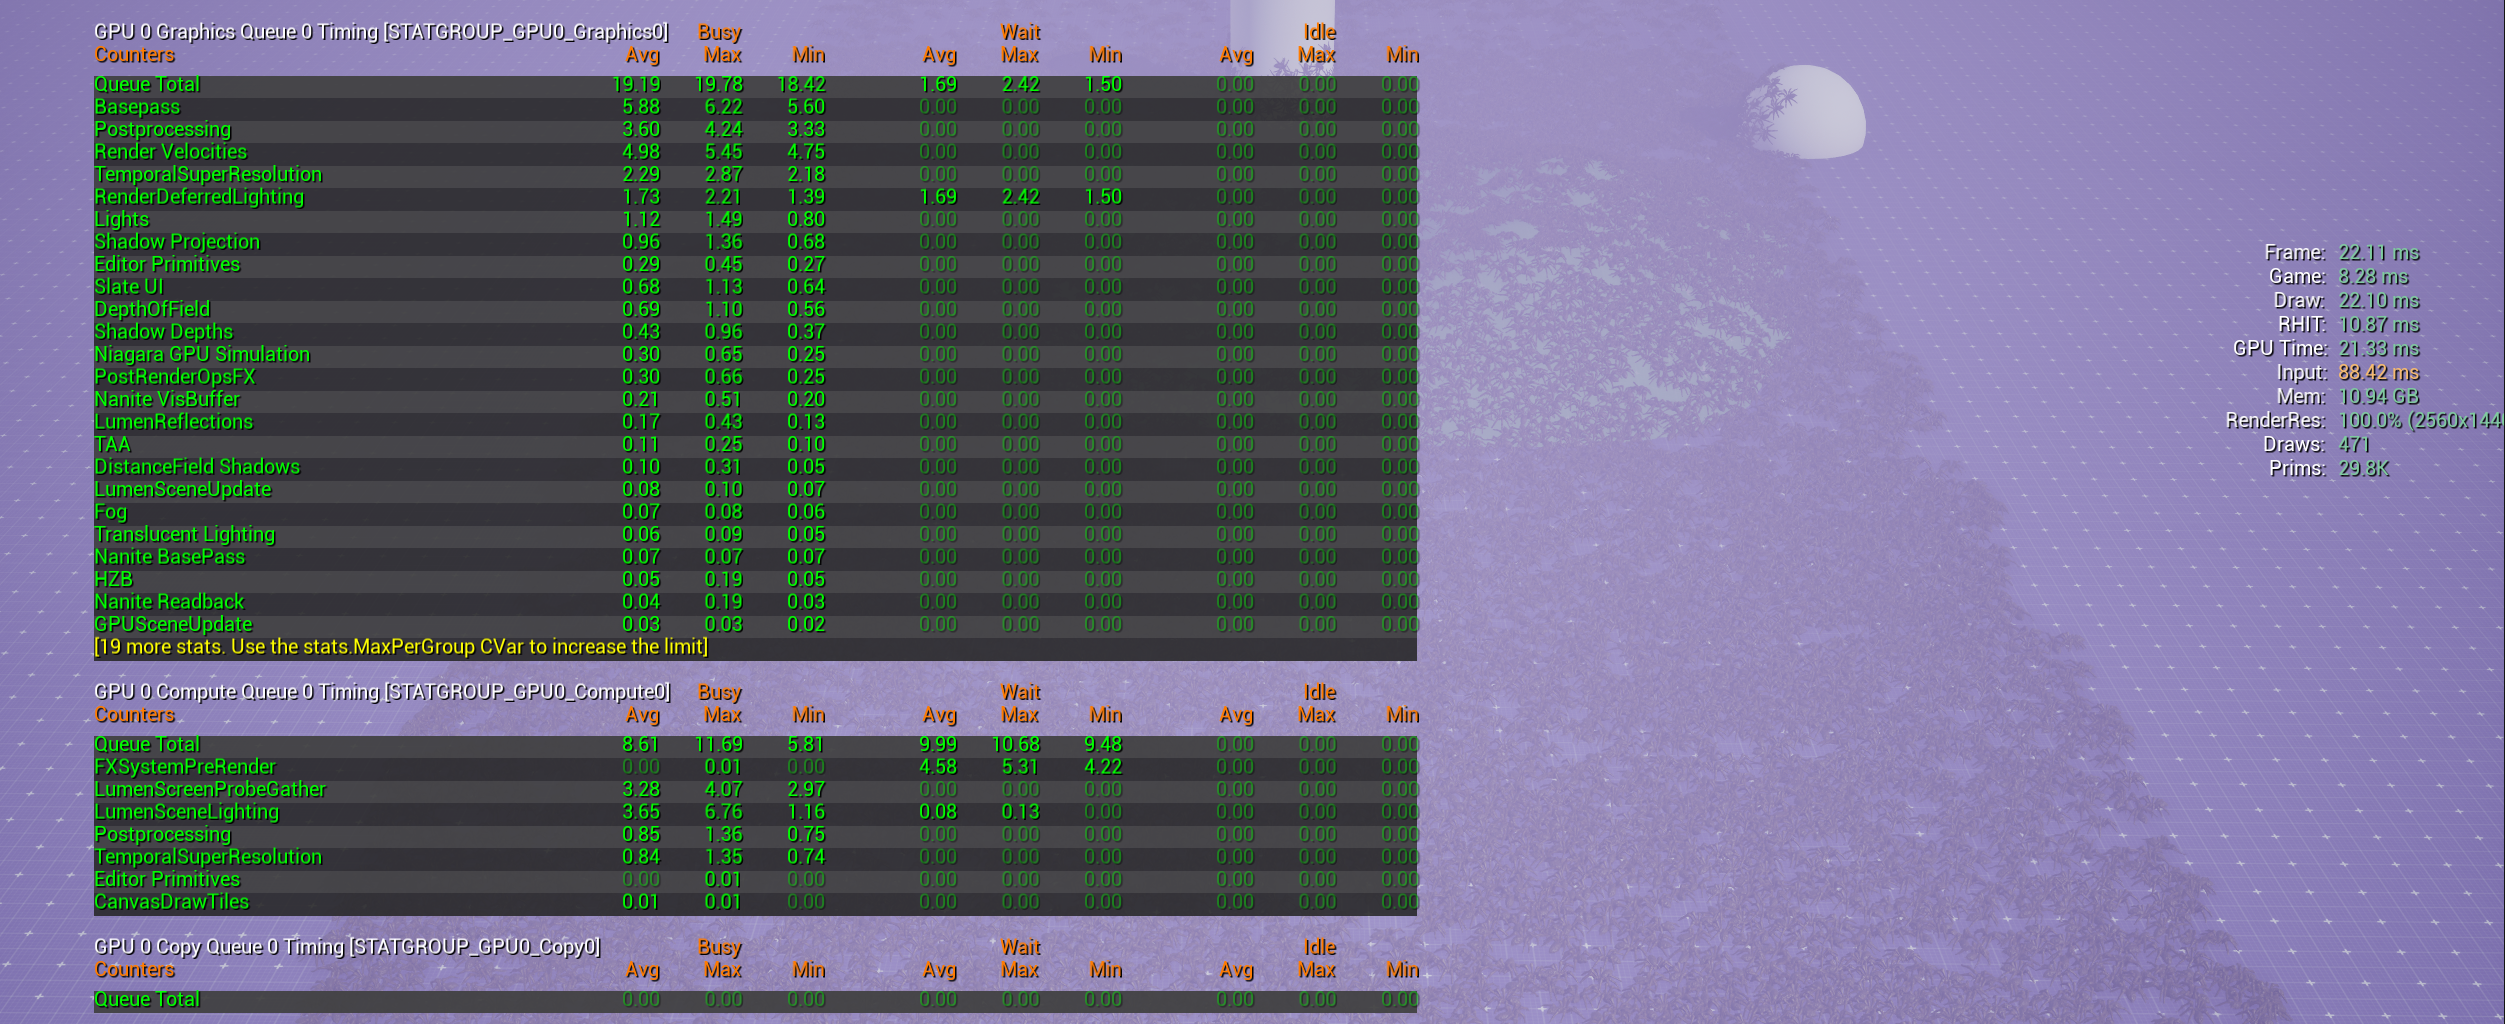
Unreal 编辑器 · 2560 × 1440 · 100% 渲染比例BasePass 为 5.88 ms,Velocity 为 4.98 ms,而 Niagara 模拟为 0.30 ms。换成 Cube 后,GPU 耗时降低约 10 ms;只关闭 VAT,变化则小得多。所以我会先处理渲染成本。不过,这组测试还不能把几何、材质和像素覆盖的开销单独分开。
| 配置 | GPU 耗时 | BasePass | Velocity |
|---|---|---|---|
| LOD0 + VAT原始模型 · 7,160 三角形 | 21.13–21.33 | 5.88 | 4.98 |
| VAT 关闭当前材质开关带来的变化较小 | 20.49–20.67 | 5.37 | 4.60 |
| Cube 替换诊断实验 · 几何与外观同时变化 | 11.28–11.34 | 0.66 | 0.17 |
| LOD21,792 三角形 · 存在 VAT 变形 | 14.13–14.34 | 2.28 | 1.33 |
| Nanite Support探索实验 · 粒子实际渲染路径尚未确认 | 18.79–18.92 | 4.72 | 3.35 |
GPU 范围为配对截图读数,Pass 使用截图中的 Busy Avg。这些是编辑器对比结果,非多轮基准测试;不同 GPU 队列的 Pass 耗时不能直接相加。
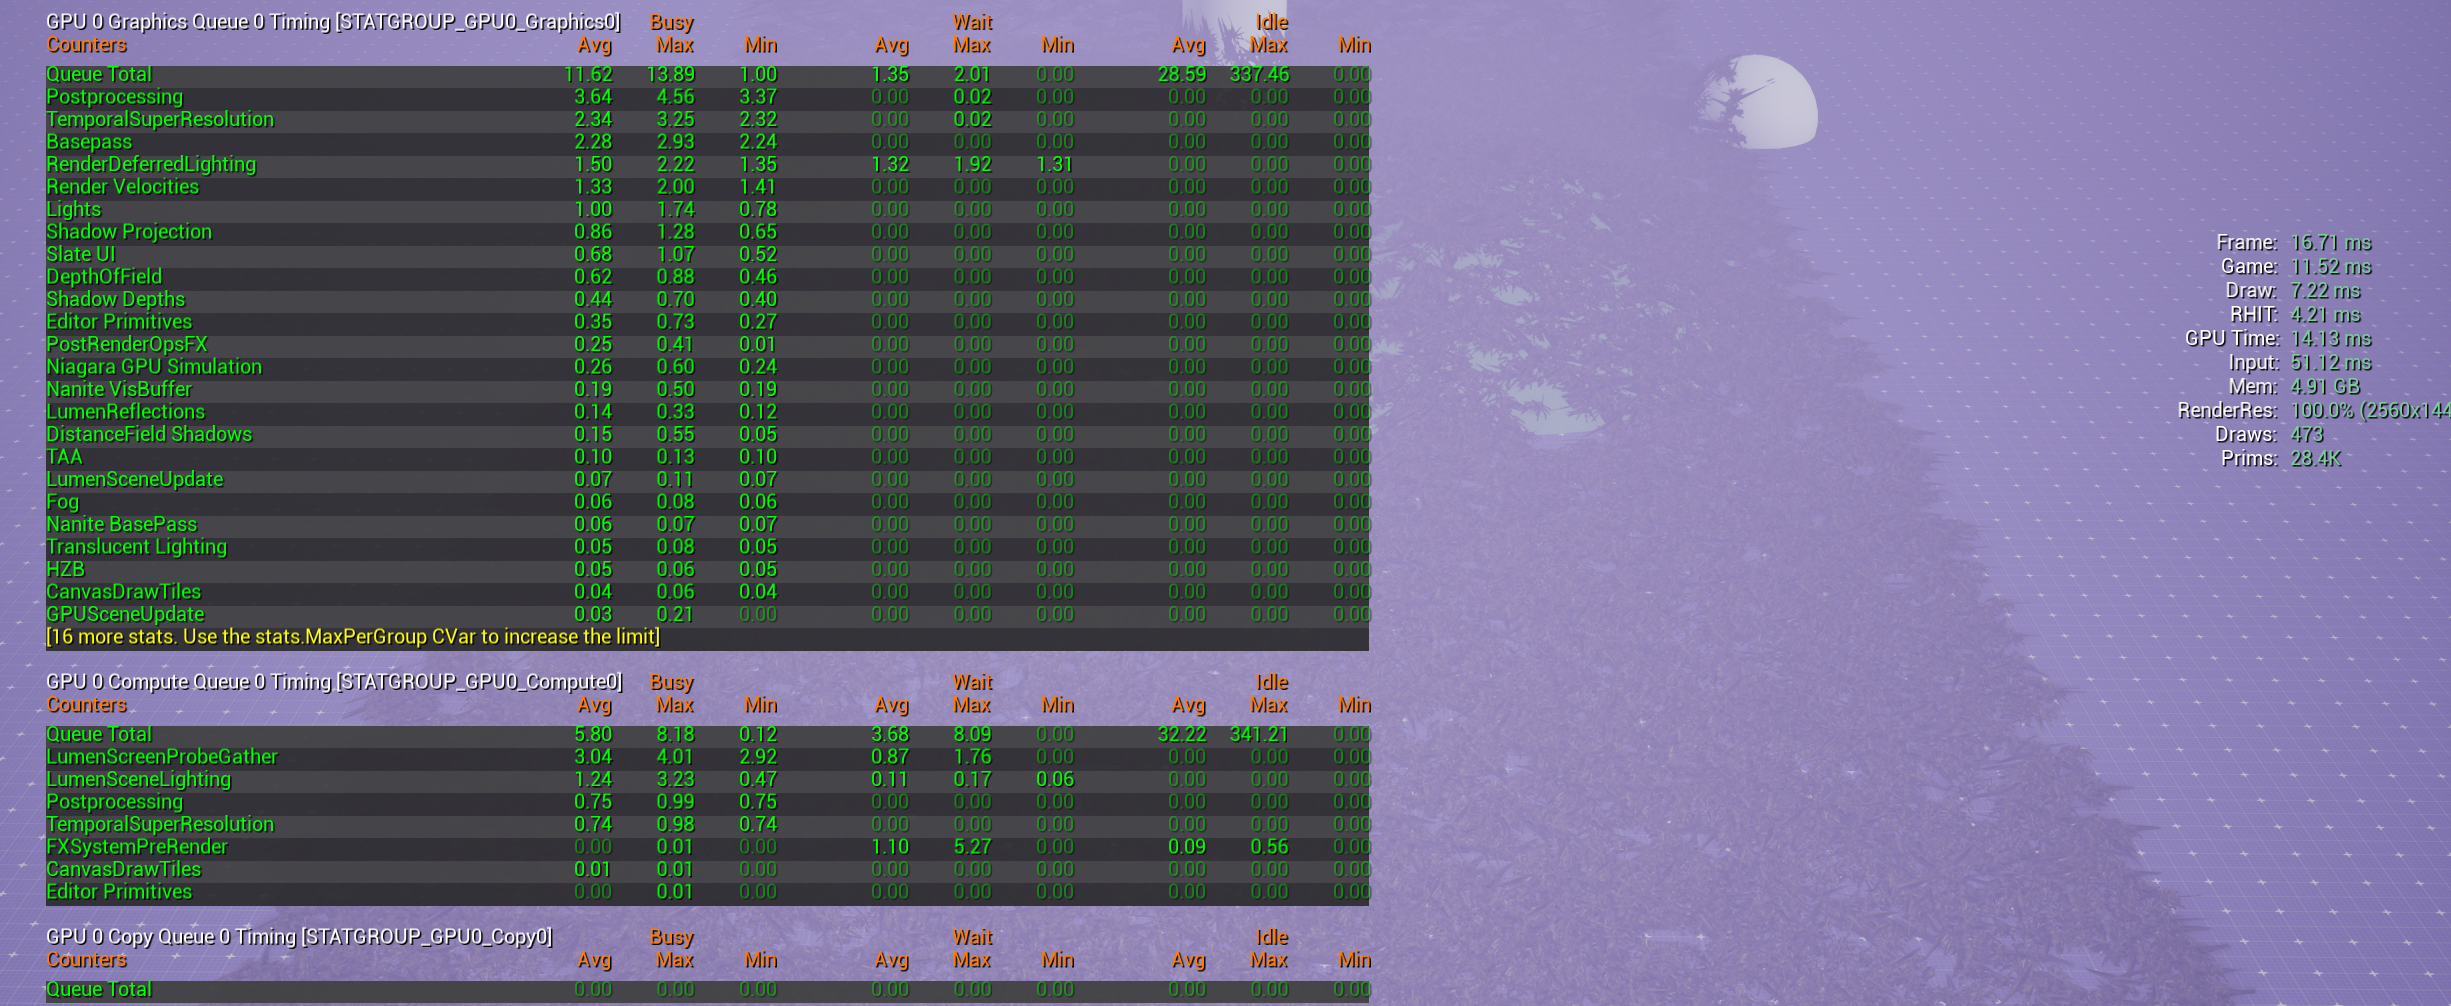
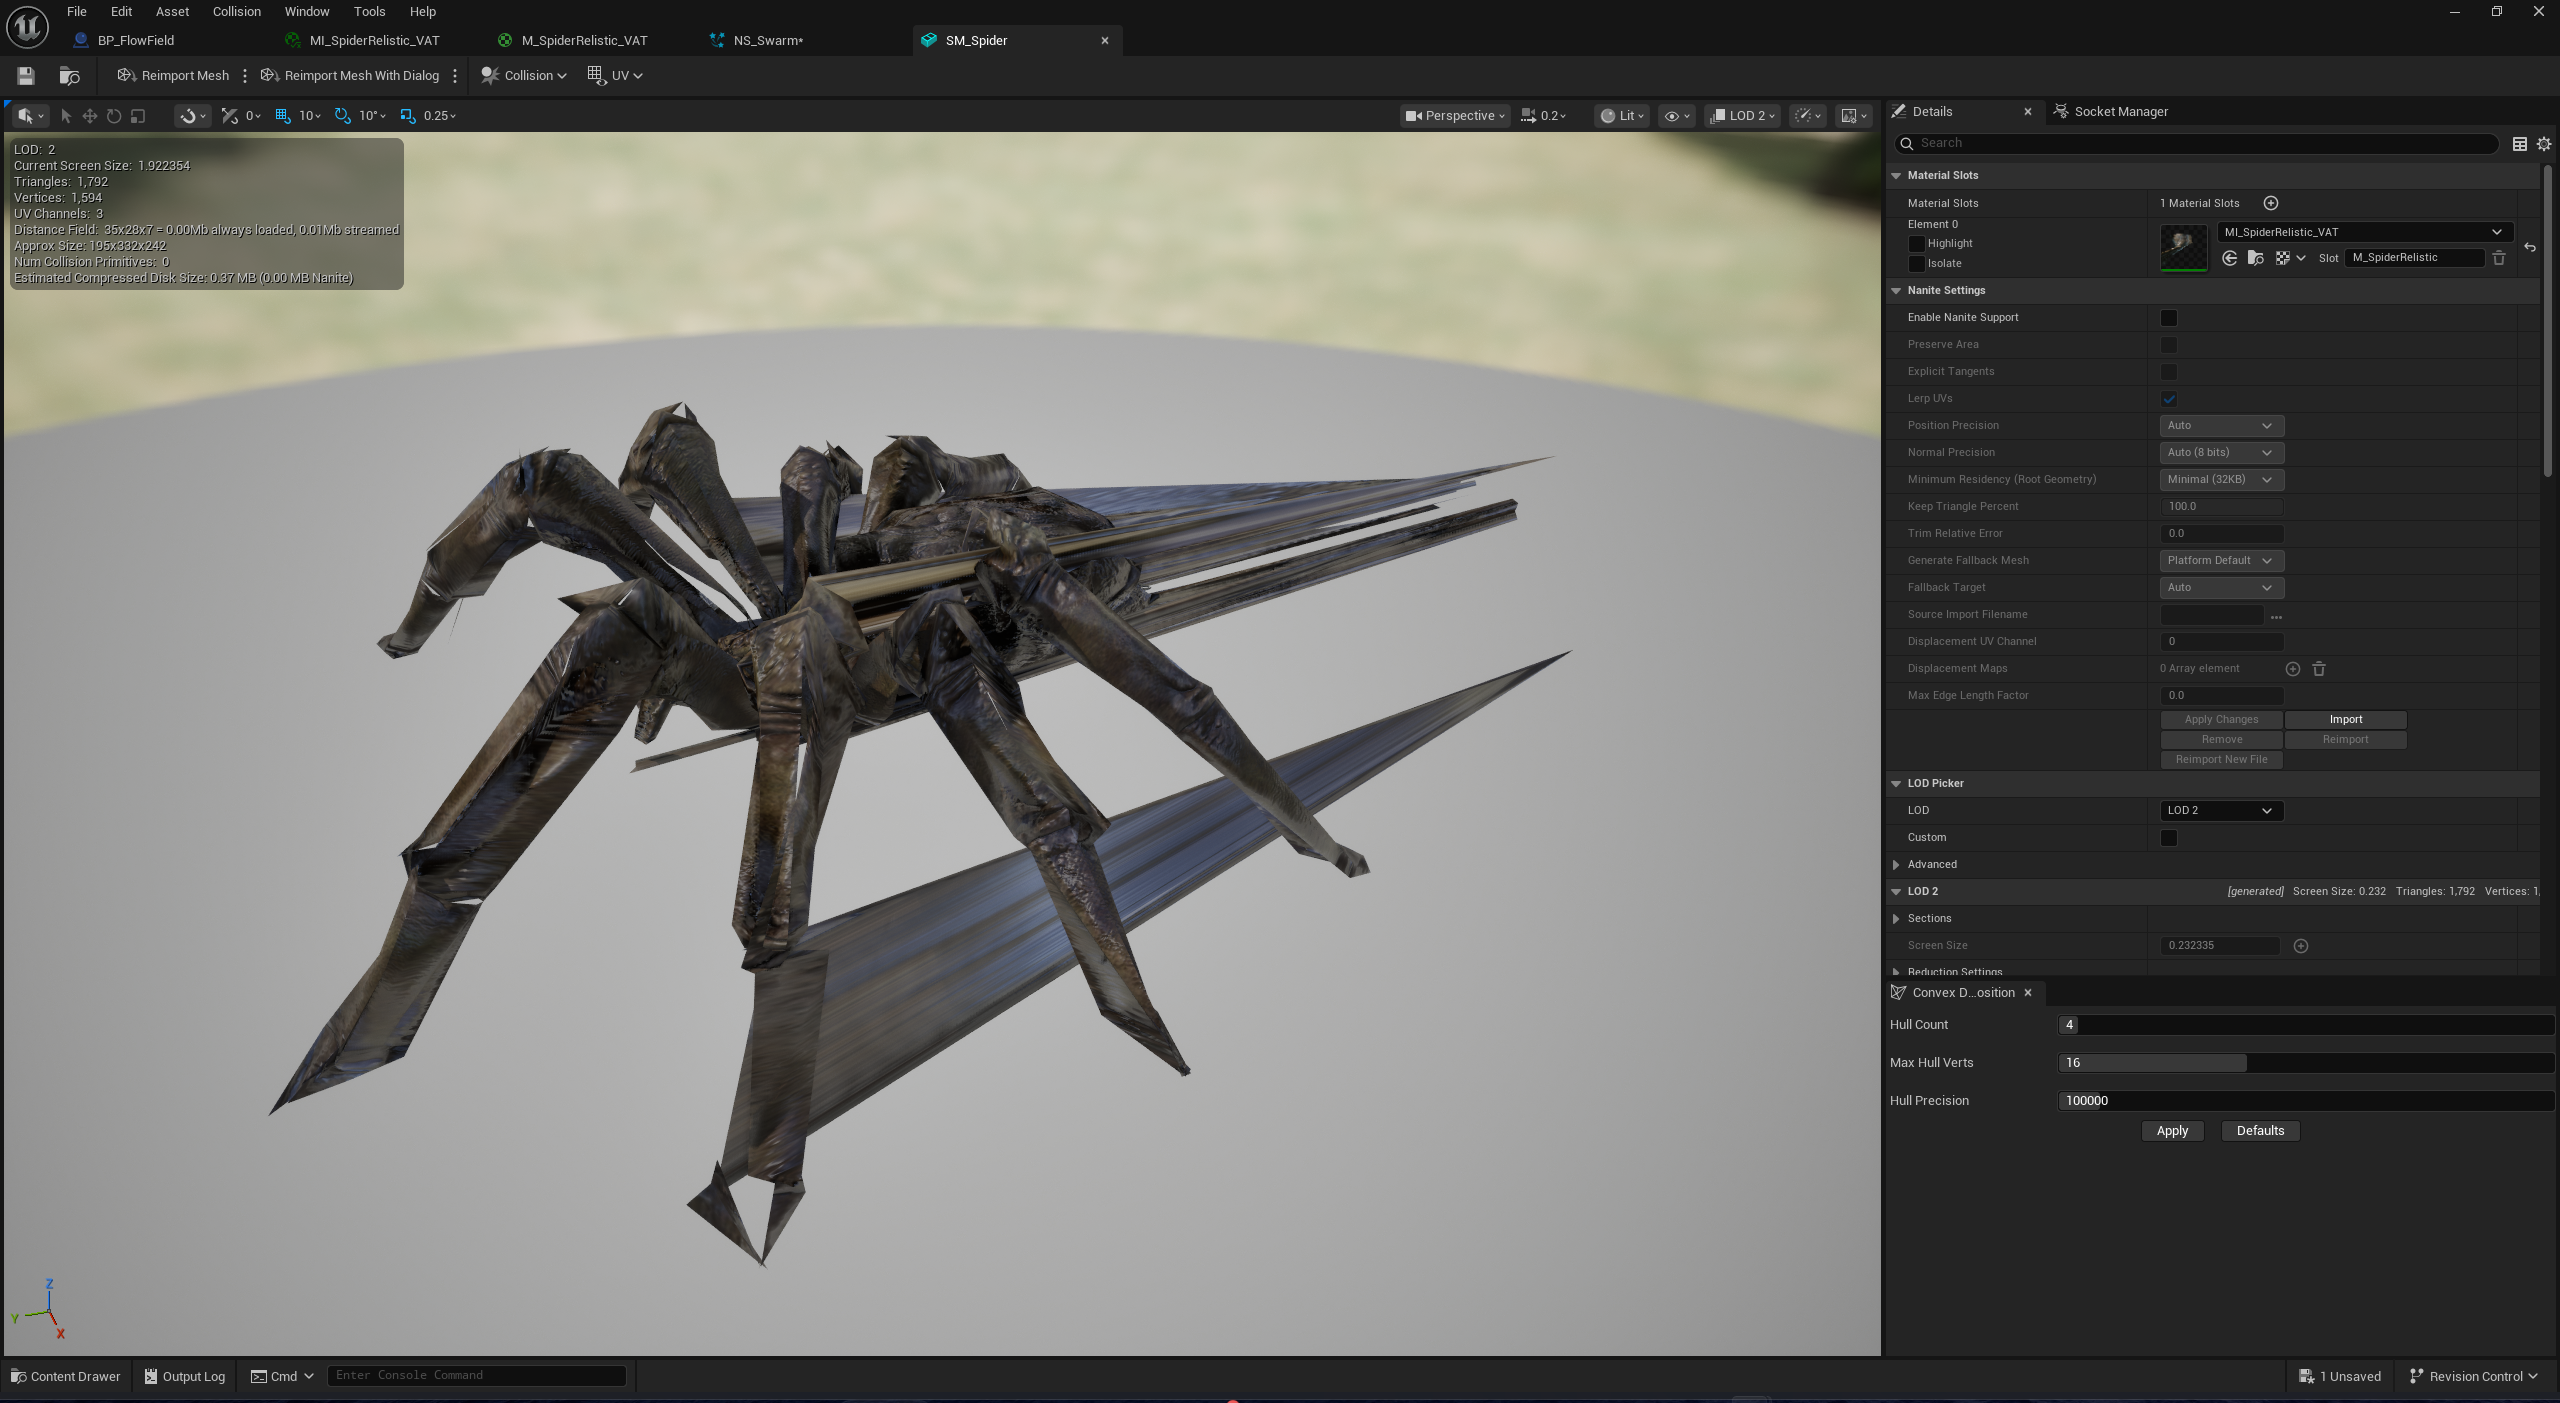
LOD2 三角形少了 75%,GPU 耗时约低了 33%,但 VAT 动画出现拉伸。要保证动画正常,可能需要针对低 LOD 模型重新烘焙 VAT,让动画数据与该 LOD 匹配。完成变形和 LOD 切换检查后,再验证同等画质下的性能收益。
从 1,000 增加到 20,000 粒子,GPU 耗时从 12.23 升到 30.95 ms。BasePass 从 1.69 升到 10.63 ms,Velocity 从 0.52 升到 9.81 ms;Niagara 模拟则在 0.21–0.57 ms 之间。这组场景里,渲染开销的增长明显快于已测到的模拟开销。
| Agents | GPU | BasePass | Velocity | Niagara 模拟 |
|---|---|---|---|---|
| 1,000 | 12.23 | 1.69 | 0.52 | 0.21 |
| 5,000 | 16.29 | 3.56 | 2.54 | 0.25 |
| 10,000 | 21.33 | 5.88 | 4.98 | 0.30 |
| 15,000 | 25.85 | 8.24 | 7.42 | 0.33 |
| 20,000 | 30.95 | 10.63 | 9.81 | 0.57 |
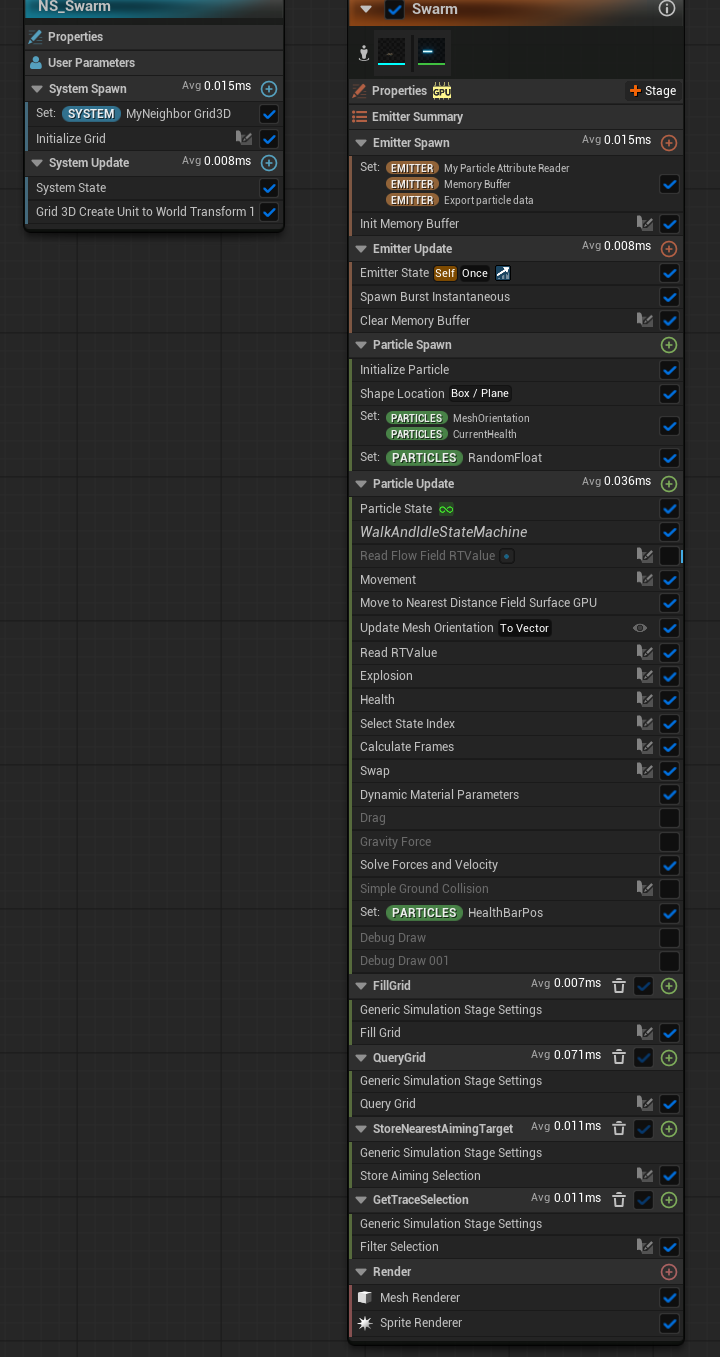
QueryGrid 为 0.071 ms,约是 Particle Update(0.036 ms)的两倍,是这次截图中耗时最高的模拟阶段。下一轮优化会围绕网格密度和查询量展开,同时检查耗时变化与虫群行为是否保持正常。
| 阶段 | Avg(ms) |
|---|---|
| QueryGrid | 0.071 |
| Particle Update | 0.036 |
| StoreNearestAimingTarget | 0.011 |
| GetTraceSelection | 0.011 |
| FillGrid | 0.007 |
独立堆栈截图 · 阶段平均耗时,非单个 Module 耗时。CPU 的 System/Emitter 与 GPU 粒子阶段分别计时,这些数值不等于整帧 Niagara 总耗时。
工具